Indice
Target: GX-TXT 0.9.8.10-dev-031
Modulo di esempio: demo.first_module
Runner: standard_octave
API principali: Standard Module API v1, Analysis Source API, TABLE_STREAM_API_v3
Livello: principiante
1. Obiettivo
Costruiremo il più piccolo modulo GX-TXT che sia davvero utile e che rispetti l'architettura del framework. Il modulo:
- compare nella lista dei moduli;
- accetta un Dataset;
- chiede all'utente di associare X e Y;
- espone due parametri di configurazione;
- legge il Dataset tramite API pubbliche;
- calcola statistiche semplici;
- scrive un file di output dichiarato.
Non crea grafici e non pubblica un Dataset derivato: sono passi successivi e qui nasconderebbero l'architettura fondamentale.
Materiale dell'esercizio
Scarica il modulo demo.first_module
Scarica first_module_sample.csv
Scarica un report atteso di riferimento
Il modulo è distribuito con licenza GPL-3.0-or-later.
2. Il flusso completo
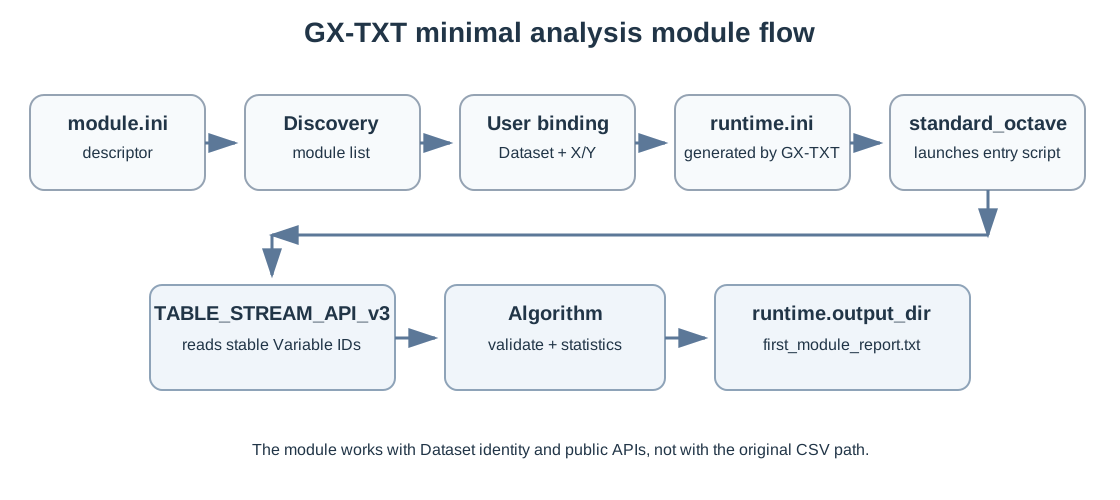
module.ini
    ↓
GX-TXT discovers the module
    ↓
user enables it
    ↓
user chooses Dataset + X/Y bindings
    ↓
GX-TXT creates runtime.ini
    ↓
standard_octave starts our script
    ↓
module reads Dataset through TABLE_STREAM_API_v3
    ↓
module calculates statistics
    ↓
module writes first_module_report.txt
    ↓
GX-TXT verifies the declared output exists
3. Il modulo di esempio
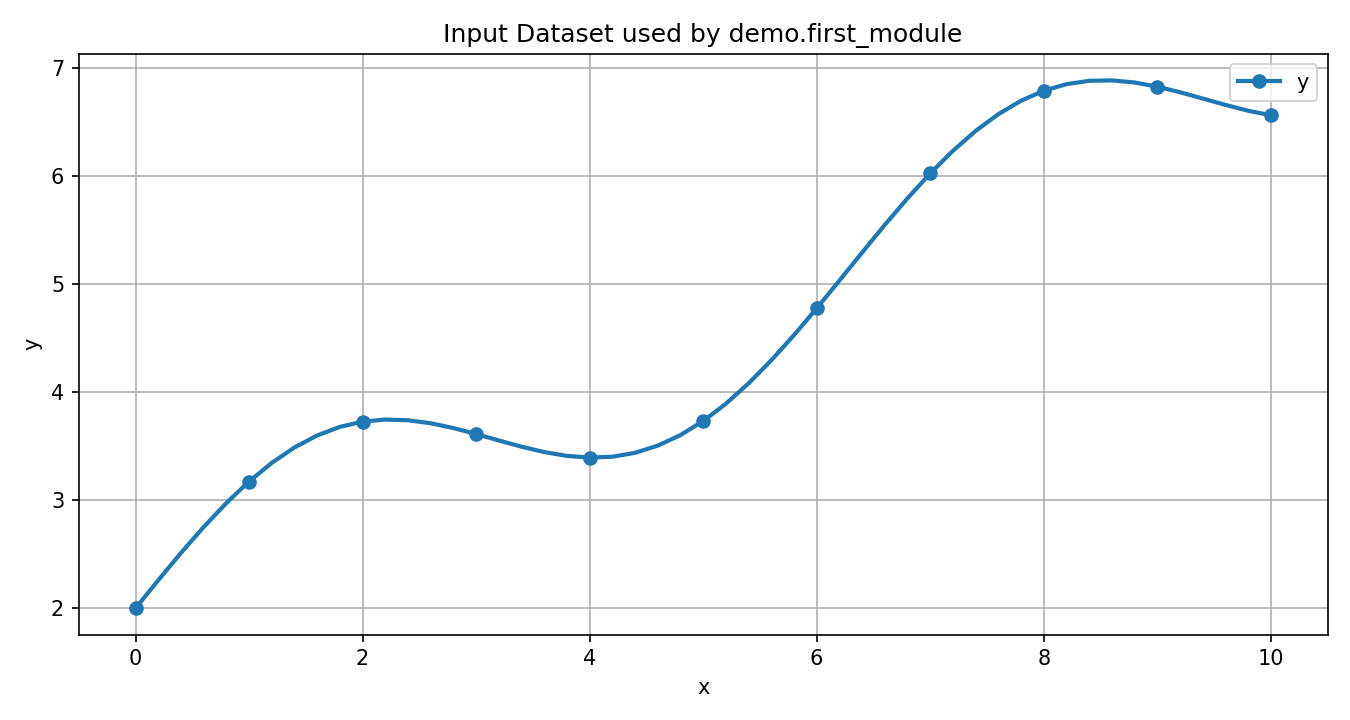
Il modulo si chiama demo.first_module; il nome mostrato nella GUI è My First GX-TXT Module. Legge un Dataset con due variabili associate ai ruoli X e Y e calcola:
- numero di coppie X/Y finite;
- minimo e massimo di X;
- minimo e massimo di Y;
- media di Y;
- media di Y moltiplicata per un fattore configurabile.
4. Anatomia di un modulo minimo
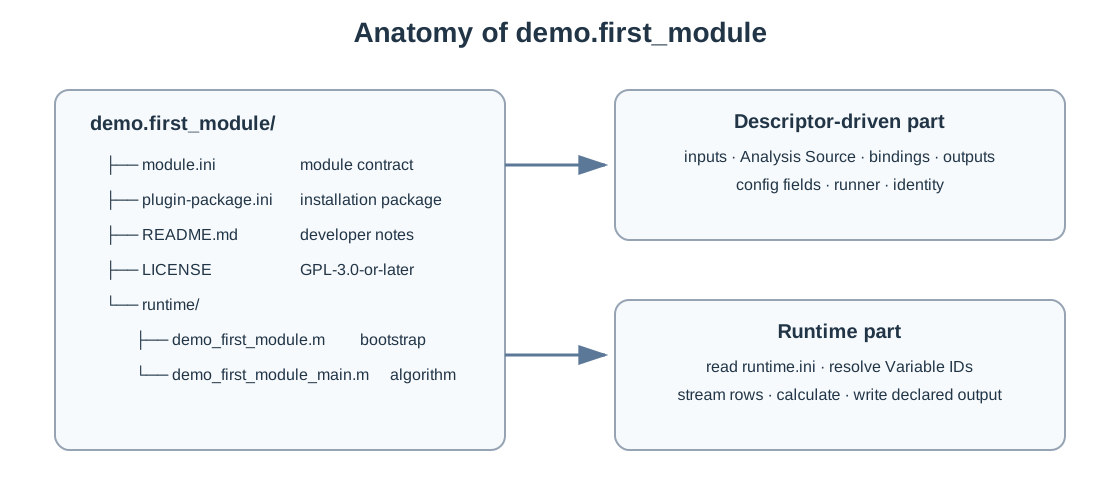
demo.first_module/
├── module.ini
├── plugin-package.ini
├── README.md
├── LICENSE
└── runtime/
    ├── demo_first_module.m
    └── demo_first_module_main.m
Per imparare, i due concetti essenziali sono module.ini e il codice runtime. plugin-package.ini serve invece alla distribuzione/installazione del modulo come pacchetto.
5. Dove GX-TXT scopre i moduli
Il descriptor deve trovarsi in:
plugins/modules/<stable-module-id>/module.iniPer l'esempio:
plugins/modules/demo.first_module/module.iniIl nome della directory e l'ID del modulo dovrebbero coincidere. Usa un ID stabile, perché entra nella persistenza della Session, negli output e in diverse identità del framework.
analysis.my_method
demo.first_module
chemistry.my_analysisMy Module
test 3 final
module_new_26. Capire module.ini
La prima sezione descrive l'identità del modulo:
; GX-TXT Standard Module API v1 descriptor
; SPDX-License-Identifier: GPL-3.0-or-later

[meta]
api_version=1
id=demo.first_module
kind=analysis
group=Generic analysis / Tutorials
name=My First GX-TXT Module
version=1.0.0
selectable=1
default_enabled=0
core=0
runner=standard_octave
order=990
description=Beginner tutorial module: reads X/Y from one Dataset through GX-TXT public Dataset APIs and writes a small statistics report.
I campi più importanti sono:
api_version=1: formato del descriptor;id: identità interna stabile;kind=analysis: il modulo è un'analisi;name: nome leggibile in GUI;version: versione del modulo;runner=standard_octave: GX-TXT prepara il runtime standard e avvia uno script Octave.
7. Dichiarare il tipo di Dataset accettato
[inputs]
contracts=table.generic
Il significato è: «questo modulo accetta un Dataset tabellare generico». Non significa che il modulo conosca un filename CSV. Il file viene importato prima in GX-TXT; il modulo lavora poi sul Dataset registrato.
8. Dichiarare l'Analysis Source
[analysis_sources]
api_version=1
ids=primary
dynamic=0

[analysis_source.primary]
required=1
contracts=table.generic
Il modulo ha una sola sorgente, chiamata primary, obbligatoria e compatibile con table.generic. Per un primo modulo è preferibile evitare sorgenti dinamiche.
9. Dichiarare i binding X e Y
[bindings]
roles=x;y

[binding.x]
label=Independent X
required=1
semantic_role=independent

[binding.y]
label=Measured Y
required=1
semantic_role=measured
Questo è un punto centrale: il modulo non assume che X sia «colonna 1» e Y «colonna 2». Dichiara due ruoli scientifici, e GX-TXT permette all'utente di associare a quei ruoli le variabili del Dataset.
Quindi Dataset con nomi diversi restano compatibili:
time_s, voltage_V   →   X=time_s, Y=voltage_V

t, signal           →   X=t,      Y=signal
10. Dichiarare gli output
[outputs]
files=first_module_report.txt
Non è una semplice nota: è un contratto. Se Octave termina con successo ma il file dichiarato non esiste, il run deve essere considerato fallito. Dichiara solo file che il codice crea davvero.
11. Dichiarare lo script del runner
[runner]
script=plugins/modules/demo.first_module/runtime/demo_first_module.m
Il framework lancia lo script e passa l'argomento standard:
--config <generated-runtime.ini>Per il primo modulo non serve inventare un protocollo CLI privato.
12. Parametri di configurazione descriptor-driven
[config]
fields=scale_factor;report_title

[config.scale_factor]
type=double
label=Scale factor applied to the reported Y mean
default=1.0
required=1

[config.report_title]
type=string
label=Report title
default=My first GX-TXT analysis
required=1
GX-TXT può generare i controlli GUI appropriati senza codice Tcl dedicato. Per impostazioni ordinarie preferisci sempre il descriptor: string, integer, double, choice, boolean, dataset, file, path.
13. Lo script di ingresso Octave
runtime/demo_first_module.m deve essere semplice: trova il framework, aggiunge le librerie standard e chiama la funzione principale.
% GX-TXT beginner tutorial module entry point.
% SPDX-License-Identifier: GPL-3.0-or-later

this_file = mfilename('fullpath');
runtime_dir = fileparts(this_file);
module_dir = fileparts(runtime_dir);
modules_dir = fileparts(module_dir);
plugins_dir = fileparts(modules_dir);
framework_root = fileparts(plugins_dir);

addpath(runtime_dir);
addpath(fullfile(framework_root,'core','octave'));
addpath(fullfile(framework_root,'core','octave','analysis'));
addpath(fullfile(framework_root,'core','octave','io'));
addpath(fullfile(framework_root,'core','octave','util'));

if (exist('demo_first_module_main','file') != 2)
  error('demo.first_module: implementation missing');
endif

demo_first_module_main(argv());
14. Perché separare entry point e implementazione
finds paths
loads libraries
calls mainreads runtime
validates inputs
performs analysis
writes outputsQuesta separazione rende il codice più leggibile e più facile da testare o estendere.
15. Recuperare --config
config_path = arg_value(args,'--config','');
if (isempty(config_path))
  error('%s: --config is required',module_id);
endif

cfg = gxtxt_ini_read(config_path);
cfg contiene lo stato runtime costruito da GX-TXT per questo run.
16. Usare runtime.output_dir
outdir = strtrim(gxtxt_ini_get(cfg,'runtime.output_dir',''));Questa directory appartiene al modulo nella Session corrente. Scrivi lì gli output dichiarati. Non creare directory arbitrarie altrove sul disco.
17. Recuperare il Dataset ID
source_dataset_id = strtrim(
  gxtxt_ini_get(cfg,'analysis_source.primary.dataset_id',''));
Questo valore è l'identità scientifica del Dataset selezionato. Il modulo non deve dipendere da un ipotetico analysis_source.primary.path.
18. Leggere i binding runtime
I binding possono apparire come primary.x e primary.y. L'helper binding_variable(...) rimuove il prefisso della sorgente e restituisce il nome da risolvere nei metadata dell'Analysis Source.
19. Risolvere lo stable Variable ID
[~,~,x_meta] = gxtxt_analysis_source_variable_meta(cfg,'primary',x_binding);
[~,~,y_meta] = gxtxt_analysis_source_variable_meta(cfg,'primary',y_binding);

x_id = x_meta.variable_id;
y_id = y_meta.variable_id;
È lo stable Variable ID che deve essere passato alle Dataset API. Non un indice di colonna.
20. La chiamata più importante del tutorial
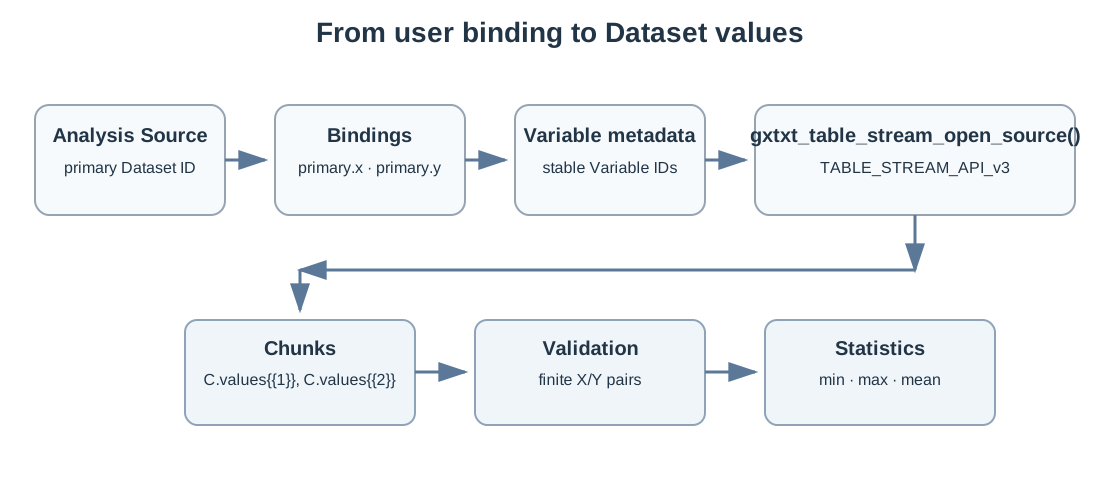
S = gxtxt_table_stream_open_source(
      cfg,
      'primary',
      {x_id,y_id},
      4096,
      struct('start',0,'count',-1,'require_direct',false));
Questa funzione usa TABLE_STREAM_API_v3. Il modulo non analizza un CSV: chiede a GX-TXT di fornire X e Y dal Dataset primary.
21. Perché non usare fopen() sul Dataset
Il Dataset potrebbe provenire da CSV, HDF5, memoria, un importer specializzato, uno storage provider o un Dataset derivato. Se il modulo apre il file sorgente direttamente, rompe l'astrazione del framework e si lega a un formato fisico.
22. Leggere i chunk
while (!S.eof)
  [S,C] = gxtxt_table_stream_next(S);
  if (C.nrows < 1)
    continue;
  endif
  x_chunks{end+1} = double(C.values{1}(:));
  y_chunks{end+1} = double(C.values{2}(:));
endwhile
Il pattern a chunk evita di vincolare il modulo a una lettura monolitica ed è già adatto a Dataset più grandi.
23. Chiudere sempre lo stream
unwind_protect
  ... read chunks ...
unwind_protect_cleanup
  S = gxtxt_table_stream_close(S);
end_unwind_protect
unwind_protect è il modo corretto in Octave per garantire la cleanup anche quando si verifica un errore.
24. Validare i dati
valid = isfinite(x) & isfinite(y);
x = x(valid);
y = y(valid);

if (isempty(x))
  error('%s: no finite X/Y pairs remain',module_id);
endif
Il modulo filtra le coppie non finite e rifiuta un Dataset privo di dati utilizzabili.
25. Leggere i parametri del modulo
scale_factor = str2double(gxtxt_ini_get(cfg,'config.scale_factor','1.0'));
report_title = strtrim(gxtxt_ini_get(cfg,'config.report_title','My first GX-TXT analysis'));
La configurazione dichiarata in module.ini arriva al codice tramite lo stesso runtime standard.
26. Il calcolo
n = numel(x);
x_min = min(x);
x_max = max(x);
y_min = min(y);
y_max = max(y);
y_mean = mean(y);
scaled_mean = scale_factor * y_mean;
La matematica è volutamente elementare: l'obiettivo del tutorial è l'integrazione con GX-TXT, non l'algoritmo.
27. Scrivere l'output
report_path = fullfile(outdir,'first_module_report.txt');
fid = fopen(report_path,'w');
Il file corrisponde esattamente a quanto dichiarato nella sezione [outputs].
Con il CSV fornito, il contenuto numerico atteso con scale_factor=1 è:
Valid X/Y pairs: 51
X minimum: 0
X maximum: 10
Y minimum: 2
Y maximum: 6.88751768
Y mean: 4.639492948431373
Scale factor: 1
Scaled Y mean: 4.639492948431373
28. Perché registrare Dataset e Variable ID nel report
Il report include Dataset ID, X Variable ID e Y Variable ID. Non è decorazione: consente di capire da quale identità scientifica è stato prodotto il risultato e rende il file più utile fuori dalla GUI.
29. Progress API
L'esempio usa:
gxtxt_progress_start(...)
gxtxt_progress_stage(...)
gxtxt_progress_complete(...)
È opzionale per un calcolo così breve, ma mostra il pattern corretto per analisi più lunghe.
30. Installare l'esempio
Scarica demo.first_module.zip e installalo tramite il normale meccanismo Plugin/Module di GX-TXT, oppure colloca la directory del modulo nella posizione prevista dal framework se stai lavorando in un ambiente di sviluppo.
La struttura deve risultare:
plugins/modules/demo.first_module/module.iniplugin-package.ini dichiara il pacchetto come modulo installabile:
; GX-TXT Plugin Install API v1 package manifest
; SPDX-License-Identifier: GPL-3.0-or-later

[package]
api_version=1
id=demo.first_module
name=My First GX-TXT Module
version=1.0.0
type=module
framework_min=0.9.8.10
framework_max=
31. Eseguire l'esempio passo passo
- importa
first_module_sample.csvcon Generic CSV; - abilita
My First GX-TXT Module; - seleziona il Dataset come Analysis Source
primary; - associa
X → xeY → y; - lascia
scale_factor=1.0; - lascia il titolo predefinito;
- esegui il modulo;
- verifica la presenza di
first_module_report.txtnell'output del modulo.
Per il CSV fornito dovresti ottenere 51 coppie finite e una media Y di circa 4.639492948431373.
32. Cambia un parametro
Imposta:
scale_factor = 2Il Dataset non cambia, la media Y non cambia, ma Scaled Y mean deve diventare circa:
9.278985896862746Questo esercizio verifica che il parametro descriptor-driven attraversi correttamente il runtime.
33. Prima modifica del codice
Aggiungi al report, per esempio, la deviazione standard di Y:
y_std = std(y);
fprintf(fid,'Y standard deviation: %.17g
',y_std);
Non devi cambiare l'Analysis Source né il modo in cui il Dataset viene letto.
34. Prima nuova opzione di configurazione
Aggiungi un campo descriptor-driven, per esempio un booleano che abiliti o meno la deviazione standard. Il pattern corretto è:
- aggiungere il nome in
[config] fields=...; - definire
[config.nome]; - leggere
config.nomedal runtime; - usare il valore nell'algoritmo.
Non serve una finestra Tcl dedicata.
35. Errore comune: Dataset hard-coded
dataset_id = 'my_test_dataset'; % da evitareIl Dataset deve arrivare dall'Analysis Source selezionata nella Session.
36. Errore comune: nomi di colonna hard-coded
x = table(:,1);
y = table(:,2);
Il modulo deve usare binding e Variable ID, non indici fisici di colonna.
37. Errore comune: leggere il path del CSV
Il file importato è una sorgente di acquisizione, non l'interfaccia del modulo. Dopo l'import, il contratto è il Dataset GX-TXT.
38. Errore comune: modificare manualmente manifest/runtime
Non usare il runtime come file di configurazione da correggere a mano. È stato generato dal framework per rappresentare lo stato della Session.
39. Errore comune: inventare una GUI privata
Prima prova sempre a esprimere il parametro nel descriptor. Una GUI personalizzata è giustificata solo quando l'interazione richiesta non rientra nel modello standard.
40. Errore comune: dichiarare output inesistenti
Ogni file in [outputs] deve essere realmente prodotto. Se aggiungi un output, aggiungi anche il codice che lo genera.
41. Errore comune: catturare ogni errore
Non trasformare ogni problema in un warning generico. Per condizioni che rendono il risultato scientificamente non valido, lascia fallire il modulo con un messaggio chiaro.
42. Errore comune: mettere tutto nell'entry point
Mantieni il file lanciato dal runner minimale. Questo evita di mescolare bootstrap, accesso alle API, algoritmo e output nello stesso livello.
43. Che cosa questo primo modulo lascia intenzionalmente fuori
- pubblicazione di Dataset derivati;
- Graph/Plot Dataset;
- più Analysis Source;
- sorgenti dinamiche;
- selections e filtri complessi;
- API numeriche specialistiche;
- workflow interattivi avanzati.
Non sono limiti del framework: sono argomenti da introdurre dopo avere compreso il flusso minimo.
44. La versione successiva naturale
Il passo logico successivo è trasformare il modulo in un'analisi che pubblica un Dataset derivato e poi collega quel Dataset a plot.dataset, mantenendo separati:
scientific calculation
        ↓
derived Dataset publication
        ↓
Graph / presentation
45. Modello mentale per i moduli GX-TXT
Descriptor defines the contract
        ↓
GX-TXT owns discovery and UI binding
        ↓
Runtime.ini carries Session state
        ↓
Public APIs expose Dataset meaning
        ↓
Module performs scientific work
        ↓
Declared outputs are written to runtime.output_dir
Se mantieni questa separazione, il modulo resta compatibile con Dataset provenienti da origini diverse e non dipende da dettagli privati dello storage.
46. Checklist minima per un nuovo modulo
- ID stabile e directory coerente;
module.inivalido;- contract di input appropriato;
- Analysis Source dichiarata;
- binding dichiarati per i ruoli scientifici;
- runner standard quando sufficiente;
- configurazione descriptor-driven;
- accesso ai Dataset tramite API pubbliche;
- Variable ID stabili;
- stream chiuso sempre;
- output scritto in
runtime.output_dir; - solo output realmente prodotti dichiarati.
47. Esercizio finale
Crea una copia del modulo con un nuovo ID stabile, per esempio demo.first_module_stats, e aggiungi:
- un parametro booleano
include_std; - calcolo della deviazione standard di Y;
- una riga aggiuntiva nel report solo quando il parametro è attivo;
- versione
1.1.0del tuo modulo.
Non modificare il modo in cui Dataset e Variable ID vengono risolti: l'esercizio deve cambiare l'algoritmo, non il contratto con GX-TXT.
48. Sorgenti complete dell'esempio
Mostra module.ini completo
; GX-TXT Standard Module API v1 descriptor
; SPDX-License-Identifier: GPL-3.0-or-later

[meta]
api_version=1
id=demo.first_module
kind=analysis
group=Generic analysis / Tutorials
name=My First GX-TXT Module
version=1.0.0
selectable=1
default_enabled=0
core=0
runner=standard_octave
order=990
description=Beginner tutorial module: reads X/Y from one Dataset through GX-TXT public Dataset APIs and writes a small statistics report.

[inputs]
contracts=table.generic

[analysis_sources]
api_version=1
ids=primary
dynamic=0

[analysis_source.primary]
required=1
contracts=table.generic

[bindings]
roles=x;y

[binding.x]
label=Independent X
required=1
semantic_role=independent

[binding.y]
label=Measured Y
required=1
semantic_role=measured

[outputs]
files=first_module_report.txt

[runner]
script=plugins/modules/demo.first_module/runtime/demo_first_module.m

[config]
fields=scale_factor;report_title

[config.scale_factor]
type=double
label=Scale factor applied to the reported Y mean
default=1.0
required=1

[config.report_title]
type=string
label=Report title
default=My first GX-TXT analysis
required=1
Mostra demo_first_module_main.m completo
function demo_first_module_main(args)
% Minimal Dataset-native GX-TXT analysis example.
% SPDX-License-Identifier: GPL-3.0-or-later

  module_id = 'demo.first_module';

  config_path = arg_value(args,'--config','');
  if (isempty(config_path))
    error('%s: --config is required',module_id);
  endif

  cfg = gxtxt_ini_read(config_path);

  outdir = strtrim(gxtxt_ini_get(cfg,'runtime.output_dir',''));
  if (isempty(outdir))
    error('%s: runtime.output_dir is missing',module_id);
  endif
  if (exist(outdir,'dir') != 7)
    mkdir(outdir);
  endif

  source_dataset_id = strtrim(gxtxt_ini_get(cfg,'analysis_source.primary.dataset_id',''));
  if (isempty(source_dataset_id))
    error('%s: primary Analysis Source Dataset ID is missing',module_id);
  endif

  x_binding = binding_variable(gxtxt_ini_get(cfg,'bindings.x',''),'x');
  y_binding = binding_variable(gxtxt_ini_get(cfg,'bindings.y',''),'y');
  if (isempty(x_binding) || isempty(y_binding))
    error('%s: X and Y bindings are required',module_id);
  endif

  [~,~,x_meta] = gxtxt_analysis_source_variable_meta(cfg,'primary',x_binding);
  [~,~,y_meta] = gxtxt_analysis_source_variable_meta(cfg,'primary',y_binding);

  if (!meta_found(x_meta))
    error('%s: X binding cannot be resolved: %s',module_id,x_binding);
  endif
  if (!meta_found(y_meta))
    error('%s: Y binding cannot be resolved: %s',module_id,y_binding);
  endif

  x_id = strtrim(x_meta.variable_id);
  y_id = strtrim(y_meta.variable_id);
  if (isempty(x_id) || isempty(y_id))
    error('%s: stable Variable IDs are required',module_id);
  endif

  scale_factor = str2double(gxtxt_ini_get(cfg,'config.scale_factor','1.0'));
  if (!isfinite(scale_factor))
    error('%s: scale_factor must be numeric and finite',module_id);
  endif

  report_title = strtrim(gxtxt_ini_get(cfg,'config.report_title','My first GX-TXT analysis'));
  if (isempty(report_title))
    report_title = 'My first GX-TXT analysis';
  endif

  gxtxt_progress_start('load','Reading Dataset through TABLE_STREAM_API_v3','indeterminate');

  S = gxtxt_table_stream_open_source(
        cfg,
        'primary',
        {x_id,y_id},
        4096,
        struct('start',0,'count',-1,'require_direct',false));

  x_chunks = {};
  y_chunks = {};
  total_rows = 0;

  unwind_protect
    while (!S.eof)
      [S,C] = gxtxt_table_stream_next(S);
      if (C.nrows < 1)
        continue;
      endif
      x_chunks{end+1} = double(C.values{1}(:));
      y_chunks{end+1} = double(C.values{2}(:));
      total_rows += C.nrows;
    endwhile
  unwind_protect_cleanup
    S = gxtxt_table_stream_close(S);
  end_unwind_protect

  if (total_rows < 1)
    error('%s: the selected Dataset contains no rows',module_id);
  endif

  x = vertcat(x_chunks{:});
  y = vertcat(y_chunks{:});

  valid = isfinite(x) & isfinite(y);
  x = x(valid);
  y = y(valid);

  if (isempty(x))
    error('%s: no finite X/Y pairs remain',module_id);
  endif

  n = numel(x);
  x_min = min(x);
  x_max = max(x);
  y_min = min(y);
  y_max = max(y);
  y_mean = mean(y);
  scaled_mean = scale_factor * y_mean;

  gxtxt_progress_stage('report','Writing report','indeterminate');

  report_path = fullfile(outdir,'first_module_report.txt');
  fid = fopen(report_path,'w');
  if (fid < 0)
    error('%s: cannot create report',module_id);
  endif

  unwind_protect
    fprintf(fid,'%s\n',report_title);
    fprintf(fid,'%s\n\n',repmat('=',1,length(report_title)));
    fprintf(fid,'Module: %s\n',module_id);
    fprintf(fid,'Source Dataset: %s\n',source_dataset_id);
    fprintf(fid,'X variable ID: %s\n',x_id);
    fprintf(fid,'Y variable ID: %s\n',y_id);
    fprintf(fid,'Valid X/Y pairs: %d\n\n',n);

    fprintf(fid,'X minimum: %.17g\n',x_min);
    fprintf(fid,'X maximum: %.17g\n\n',x_max);

    fprintf(fid,'Y minimum: %.17g\n',y_min);
    fprintf(fid,'Y maximum: %.17g\n',y_max);
    fprintf(fid,'Y mean: %.17g\n\n',y_mean);

    fprintf(fid,'Scale factor: %.17g\n',scale_factor);
    fprintf(fid,'Scaled Y mean: %.17g\n',scaled_mean);
  unwind_protect_cleanup
    fclose(fid);
  end_unwind_protect

  gxtxt_progress_complete('done',sprintf('Report written from %d valid X/Y pairs',n));

  fprintf('[%s] Dataset=%s rows=%d y_mean=%.17g scaled_mean=%.17g\n',
          module_id,source_dataset_id,n,y_mean,scaled_mean);
endfunction

function value = arg_value(args,key,default)
  value = default;
  for i = 1:(numel(args)-1)
    if (strcmp(args{i},key))
      value = args{i+1};
      return;
    endif
  endfor
endfunction

function out = binding_variable(value,role)
  value = strtrim(value);
  if (isempty(value) || strcmp(value,'auto'))
    out = '';
    return;
  endif

  dot = find(value=='.',1);
  if (!isempty(dot))
    out = value(dot+1:end);
  else
    out = value;
  endif

  if (isempty(out))
    error('demo.first_module: invalid %s binding',role);
  endif
endfunction

function tf = meta_found(meta)
  tf = isstruct(meta) && isfield(meta,'found') && meta.found;
endfunction
49. Dove continuare nella documentazione
- Scrivere script GNU Octave / MATLAB-like per le API di scripting;
- Script Module Builder per trasformare script in moduli installabili;
- Script Bridge API per il riferimento delle API pubbliche;
- Dataset e Variable ID per approfondire identità e schema delle variabili;
- Generic CSV per l'importazione del Dataset di prova.
50. Cosa hai imparato
Dopo questo tutorial dovresti saper distinguere chiaramente il descriptor del modulo, lo stato runtime creato da GX-TXT e il codice scientifico. Soprattutto, dovresti saper scrivere un modulo che riceve Dataset e variabili attraverso Analysis Source e binding, legge i valori con TABLE_STREAM_API_v3 e produce un output dichiarato senza dipendere da percorsi o colonne hard-coded.