Indice
Versione verificata
| Framework | GX-TXT 0.9.8.10-dev-031 |
|---|---|
| Data verifica | 3 ottobre 2026 |
1. Perché esiste GX-TXT
Un normale script scientifico può leggere un file, eseguire un calcolo e produrre un grafico. Il problema inizia quando lo stesso lavoro deve diventare riutilizzabile: più Dataset, più formati, versioni diverse dello script, parametri persistenti, grafici modificabili, output derivati, confronto fra Session e necessità di sapere esattamente quale sorgente ha prodotto quale risultato.
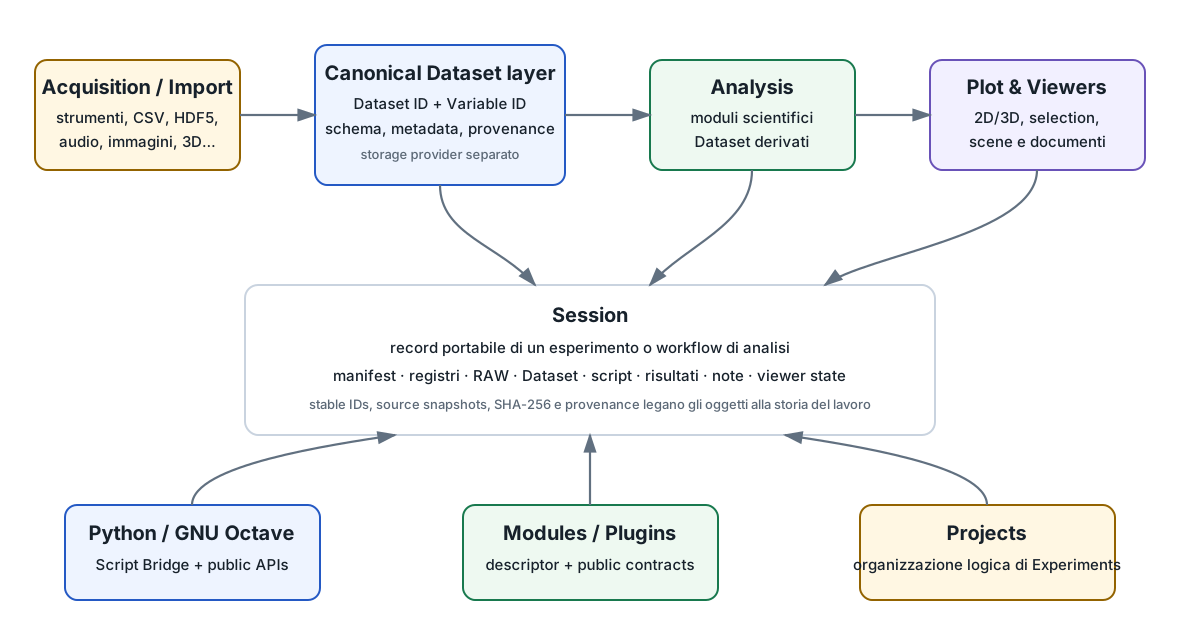
GX-TXT affronta questo problema costruendo una infrastruttura comune attorno al calcolo scientifico. I dati sono registrati come Dataset canonici; gli algoritmi diventano moduli o script che usano API pubbliche; la Session mantiene configurazione, provenance e risorse; plotting e viewer restano separati dal dato scientifico.
2. Il concetto più importante: identità scientifica separata dal file
In GX-TXT un Dataset non è semplicemente «quel CSV». Un Dataset possiede un Dataset ID stabile, un contratto scientifico, schema delle variabili, metadata e provenance. Il file CSV, HDF5 o binario è il modo in cui il provider memorizza il payload.
La stessa idea vale per le variabili: l'identità stabile è dataset_id + variable_id, non il numero della colonna o il path interno di un oggetto HDF5.
3. Session: il record del lavoro
Una Session è il record portabile di un esperimento o di un workflow di analisi. Contiene o indicizza la configurazione, i Dataset, i sorgenti, le note, gli script registrati, i risultati di analisi, i grafici e lo stato dei viewer.
Il file metadata/manifest.ini conserva lo stato framework-owned principale; metadata/datasets.ini indicizza i Dataset. Altre risorse persistenti hanno propri registri o sidecar, ma appartengono sempre alla Session.
La Session non è un Project. Un Project organizza uno o più Experiments tramite identità persistenti; l'Experiment descrive lo studio scientifico; la Session ne conserva il record operativo. Vedi Projects, Experiments e Sessions.
4. Workflow tipico
- Importare o acquisire una sorgente.
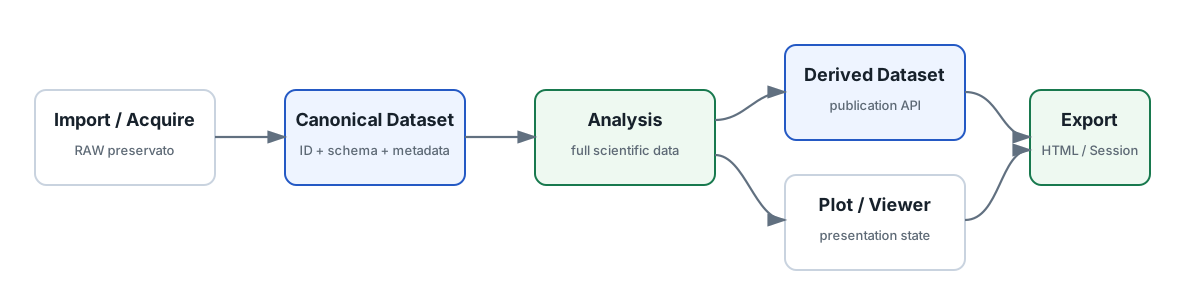
- Preservare il RAW e registrare il Dataset canonico.
- Descrivere variabili, unità, semantica e metadata.
- Selezionare uno o più Dataset come Analysis Sources.
- Eseguire moduli scientifici o script Python/Octave.
- Pubblicare Dataset derivati o file attraverso le API appropriate.
- Creare grafici o scene 3D mantenendo separate identità scientifica e presentazione.
- Salvare la Session e, quando serve, esportarla o renderla portabile.
5. Analysis modules
I moduli Analysis dichiarano ciò che richiedono attraverso descriptor: Analysis Sources, variable bindings, configuration fields, output e graph offerings. CORE genera la configurazione standard e persiste i valori nella Session.
Il modulo dovrebbe descrivere che cosa gli serve; non dovrebbe hardcodare dove si trova il dato. Quando gli input sono multipli, l'Analysis Source Map rende esplicito il ruolo di ogni Dataset.
6. Plotting e viewer
Un grafico persistente non è il Dataset. Plot Dataset usa Graph Series e PlotSpec per legare Dataset/Variable ID a una rappresentazione. Variant, assi, stili, pannelli e rendering sono presentazione persistente sopra identità scientifiche già registrate.
I viewer interattivi seguono lo stesso principio. Scene/layer state e Interactive Documents possono essere persistenti, ma non devono sostituire Dataset o altre risorse autorevoli.
7. Python e GNU Octave
Gli script di ricerca possono essere registrati con identità stabile nella Script Library o nella Session. Python e Octave usano lo stesso modello Script Bridge per scoprire e invocare API pubbliche script-callable.
Lo script riceve il contesto della run, gli input risolti, i parametri, l'output directory e può usare servizi pubblici per Dataset, numerica, plotting, publication, progress e altre funzioni.
Se uno script deve diventare distribuibile come normale Analysis module, Script Module Builder crea un package installabile senza riscrivere il sorgente scientifico.
8. Provenance e riproducibilità
GX-TXT conserva identità e informazioni sufficienti a ricostruire la storia del lavoro: Dataset ID, producer, module version, source snapshot, revision, SHA-256, required APIs, configurazione e runtime information dove previsto.
La provenance non significa che ogni output sia eterno o immutabile: significa che il framework distingue stato autorevole, stato derivato e cache, e che le operazioni significative non devono dipendere da side effect invisibili.
9. Stato autorevole, stato derivato e cache
| Categoria | Esempi | Regola |
|---|---|---|
| Autorevole | Dataset registry, Variable Schema, Interactive Documents, Session script source | Non deve scomparire quando si ricostruisce una cache. |
| Persistente di presentazione | Plot Variant, Viewer scene/layer state, assi | Può essere ricostruito o sincronizzato dal proprio modello pubblico. |
| Derivato/runtime | runtime.ini, render cache, temporary transport | Non è identità scientifica né sorgente primaria. |
10. Estendere GX-TXT
Le estensioni devono preferire descriptor e API pubbliche. Un plugin può aggiungere acquisition handler, Analysis module, viewer, public API o altri servizi supportati. Il principio è evitare che un componente dipenda da strutture private di CORE quando esiste un contratto pubblico equivalente.
11. Dove continuare
- Dataset e Variable ID — il modello dei dati.
- Session Explorer e risorse — ciò che vive nella Session.
- Projects, Experiments e Sessions — organizzazione, identità Experiment e storage Session.
- Scrivere script GNU Octave / MATLAB-like.
- Scrivere script Python.
- Scientific Dataset Plot.
- Script Module Builder.
Riferimento tecnico completo
Questa parte raccoglie integralmente la documentazione tecnica pertinente distribuita con GX-TXT per gli argomenti e i moduli trattati in questa pagina.
Getting started
Getting started
GX-TXT organizes scientific work in Sessions. Create or open a Session from the Session bar, then import source files in Acquisition. The source files remain unchanged; GX-TXT publishes canonical Datasets with provenance and variable schemas.
Choose a Dataset and an analysis module in Analysis, configure its sources and parameters, then use Run to execute it. Inspect outputs in Datasets, Plots, Viewers, and the Sessions file browser. The Session carries its metadata, scripts, analyses and output artifacts.
The main paths through the framework are documented in Sessions, Acquisition / Import, Analysis modules, and Scripting. Module manuals are listed under Plugin manuals in this browser.
Save or export a Session when you need a portable record. The offline HTML export is a read-only view and does not replace the Session archive.
Sessions
Sessions
A Session is the portable record of one experiment or analysis
workflow. Its metadata/manifest.ini stores Session
configuration; metadata/datasets.ini indexes canonical
Datasets. Source files, notes, registered Session scripts, analysis
outputs and Viewer state remain inside the Session.
Create a standalone Session under the configured storage root, or create one inside a Project. Project membership uses stable IDs and does not move an existing Session. Click the Session path in the main bar to locate it.
Use the Sessions browser to inspect Session files and registered scripts. Session scripts are physical snapshots: editing a reusable user script later does not silently alter the Session copy.
See Datasets and Scripting for the content stored in a Session.
Datasets
Datasets
Each imported or computed Dataset has a stable ID, scientific contract, variable schema and provenance. Acquisition preserves the RAW source and publishes canonical data; analysis modules publish further Datasets through the Dataset Publication API.
Inspect and edit variable labels, units, semantic roles and Use flags through the Dataset view. These interpretation changes do not rewrite the original source. Attach scientific notes to a Dataset when needed; they remain separate from producer metadata.
Analysis modules select Datasets by ID, and modules with several inputs use a source map. A source map selects inputs; scientific alignment, joins and resampling remain explicit operations.
See Acquisition / Import and Analysis modules.
Analysis modules
Analysis modules
Select an enabled analysis module and its canonical Dataset sources. The module configuration shows parameters and variable bindings. Where a module accepts several sources, assign a Dataset to each declared Source ID.
Use Run to review and execute the configured work. Standard Octave modules run through the checked framework runner. A run fails if execution fails or required declared outputs are missing. Published results are available through the Dataset registry, Session files and relevant plots.
Module-specific scientific meaning, assumptions and output interpretation belong to the plugin manual. Select a module in Modules and choose Open module manual… to read it here.
Plotting
Plotting
Plots are derived views of Session data. Graph and Plot Providers declare their available series, axes and interactions. Configure units, ranges, legends and annotations from the Plots page where supported.
Legend placement and entry layout are separate settings. Annotations are non-destructive; saving them records metadata, while exporting or printing creates a rendered result. Rerendering from a module’s cache can change presentation without repeating its numerical analysis when that module supports it.