Versione verificata
| Framework | GX-TXT 0.9.8.10-dev-031 |
|---|---|
| API matematica | NUMERIC_API_v1; non esiste una separata “STATISTICS_API_v1” nella dev-031. |
1. Che cos'è la statistica?
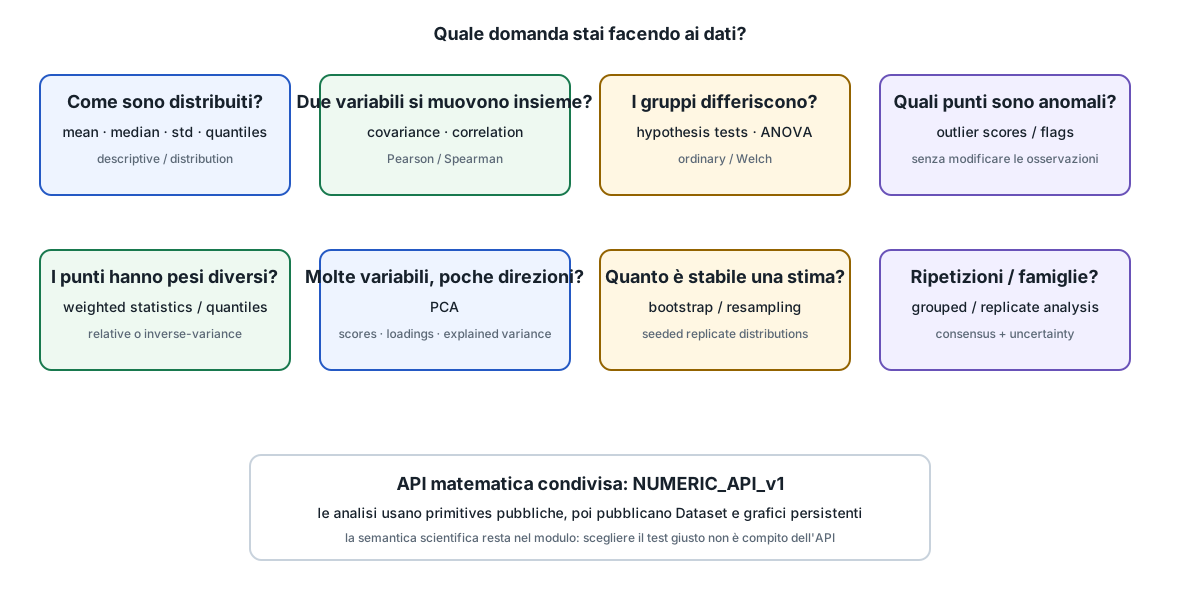
La statistica cerca di descrivere variabilità e incertezza e di distinguere pattern plausibili da differenze che potrebbero essere spiegate dal rumore o dal campionamento. Non esiste un unico “test statistico”: la domanda scientifica e il modo in cui i dati sono stati raccolti determinano quale metodo ha senso.
2. Concetti minimi
| Media / mediana | Misure di posizione centrale; la mediana è più robusta agli estremi. |
|---|---|
| Varianza / deviazione standard | Misure della dispersione attorno al centro. |
| Quantili | Soglie che suddividono la distribuzione, per esempio mediana = 50° percentile. |
| Covariance / correlation | Misurano co-variazione; la correlazione non dimostra causalità. |
| Hypothesis test | Confronta i dati con una ipotesi nulla secondo un test dichiarato. |
| ANOVA | Confronta la variabilità fra gruppi con quella all'interno dei gruppi. |
| PCA | Rappresenta variabili correlate con nuove direzioni che catturano molta varianza. |
| Bootstrap/resampling | Costruisce distribuzioni empiriche di una stima ripetendo campionamenti controllati. |
3. Moduli presenti nella dev-031
| ID | Nome | Versione | Tipo | Scopo |
|---|---|---|---|---|
analysis.statistics.descriptive | Descriptive Statistics | 1.1.0 | analysis | Statistiche descrittive + histogram/box-whisker Plot Dataset. |
analysis.statistics.grouped | Grouped Statistics | 1.0.0 | analysis | Statistiche per gruppi categoriali o numerici. |
analysis.statistics.correlation | Covariance and Correlation | 1.0.1 | analysis | Covariance/correlation con missing-data policy. |
analysis.statistics.distribution | Empirical Distribution | 1.0.1 | analysis | Istogramma/ECDF e distribuzioni empiriche riproducibili. |
analysis.statistics.outliers | Outlier Flags | 1.0.1 | analysis | Score, limiti e flag mantenendo source-row identity. |
analysis.statistics.weighted | Weighted Statistics | 1.0.1 | analysis | Statistiche e quantili con pesi. |
analysis.statistics.tests | Hypothesis Tests | 1.0.1 | analysis | Test di ipotesi tramite NUMERIC_API. |
analysis.statistics.anova | One-way ANOVA | 1.0.1 | analysis | ANOVA one-way ordinaria o Welch. |
analysis.statistics.pca | Principal Component Analysis | 1.0.1 | analysis | Scores, loadings, explained variance e scaling. |
analysis.statistics.resampling | Resampling Inference | 1.0.1 | analysis | Distribuzioni di replicate seeded e summary. |
analysis.regression | Regression | 1.0.1 | cross-area | Regression numerica con coefficienti/covariance/metrics. |
curve.replicate_analysis | Replicate Curve Analysis | 8 | cross-area | Consensus e uncertainty su curve ripetute; non fitta un modello fisico. |
demo.numeric.statistics | Numerical Statistics Demo | 1.0.1 | reference/demo | Descriptive + weighted statistics. |
demo.numeric.uncertainty | Numerical Uncertainty Demo | 1.0.1 | reference/demo | Uncertainty propagation + weighted estimation. |
4. API statistica effettiva
Le primitive statistiche vivono in NUMERIC_API_v1: descriptive statistics, rank, covariance, Pearson/Spearman correlation, MAD, histogram, ECDF, quantili, weighted quantiles/statistics, hypothesis tests, one-way ANOVA, SVD/PCA building blocks, seeded resampling e una famiglia foundation.statistics con confidence interval, robust methods, multiple testing, bootstrap/permutation, logistic regression, GLM, survival e k-means.
5. Missing/non-finite data
Molte primitive richiedono una policy esplicita error o omit. Le analisi di correlation possono distinguere pairwise e listwise policies. Questo è parte del significato scientifico: eliminare osservazioni non finite cambia il campione.
6. Pesi
I pesi non sono automaticamente “incertezze”. NUMERIC_API_v1 distingue semantiche relative e inverse-variance nelle operazioni di fitting/statistica che lo prevedono. Zero-weight observations vengono escluse, mentre il conteggio resta diagnosticabile.
7. ANOVA in parole semplici
Una one-way ANOVA chiede se le differenze fra le medie dei gruppi sono grandi rispetto alla variabilità interna ai gruppi. La variante Welch è pensata per gruppi con varianze non omogenee. Un risultato significativo non dice da solo quali gruppi differiscono o perché.
8. PCA in parole semplici
Se molte variabili misurano aspetti correlati dello stesso fenomeno, PCA costruisce nuove coordinate ortogonali (“componenti principali”) ordinate per varianza spiegata. Scores descrivono le osservazioni nel nuovo spazio; loadings descrivono quanto ogni variabile contribuisce alle componenti.
9. Replicate Curve Analysis
È una caratterizzazione statistica di curve ripetute, non un fit di modello fisico. Con replicate ID espliciti usa il percorso trace-based; senza ID non inventa un numero di repliche ma tratta le osservazioni come point cloud ripetute, stima consensus e componenti di dispersione.