Input
Più Dataset reali
Lo script riceve undici acquisizioni come normali Analysis Sources e lavora con gli ID logici dei Dataset, non con percorsi privati.
Da undici acquisizioni di oscilloscopio a un Dataset derivato e a un normale grafico GX-TXT persistente.
Questo tutorial mostra un workflow completo eseguito nel GX-TXT Octave Script Workspace. Il caso scientifico è un sweep Bode di un circuito RLC serie, ma il risultato didattico più importante è generale: uno script .m eseguito dal runtime GNU Octave di GX-TXT può produrre Dataset e grafici pienamente nativi del framework, senza scrivere file di stato privati e senza aprire una via grafica separata.
tutorial.rlc_bode_experimental, poi crea una normale Variant plot.dataset.xy con PLOT_DATASET_API_v3/create_plot. Il grafico appare nella pagina Plots e usa gli stessi controlli Axes, Legend, Graphics, Annotation, Variants, rerender ed export degli altri grafici GX-TXT.0.9.8.10-dev-037 e GNU Octave 9.4. Il descriptor depositato nella dev-037 espone analysis.octave_script 1.3.0. La caratteristica indispensabile per questo tutorial è l'esposizione Script Bridge di PLOT_DATASET_API_v3/create_plot, introdotta nella dev-037.Scarica lo script Octave provato (.m)
Lo script riceve undici acquisizioni come normali Analysis Sources e lavora con gli ID logici dei Dataset, non con percorsi privati.
Il fit sinusoidale usa NUMERIC_API_v1, compresa la risoluzione matriciale dei due canali in un'unica operazione.
Frequenza, guadagno, fase e diagnostica del fit diventano un Dataset GX-TXT riutilizzabile da altri moduli.
Il PlotSpec a due pannelli viene registrato come normale Variant di plot.dataset, non come immagine privata dello script.
Il circuito di prova è un RLC serie con uscita misurata ai capi della resistenza. I valori nominali sono:
R = 100 ΩL = 10 mHC = 1 µFLa frequenza di risonanza ideale è
\[ f_0 = \frac{1}{2\pi\sqrt{LC}} \approx 1591.55\;\mathrm{Hz}. \]
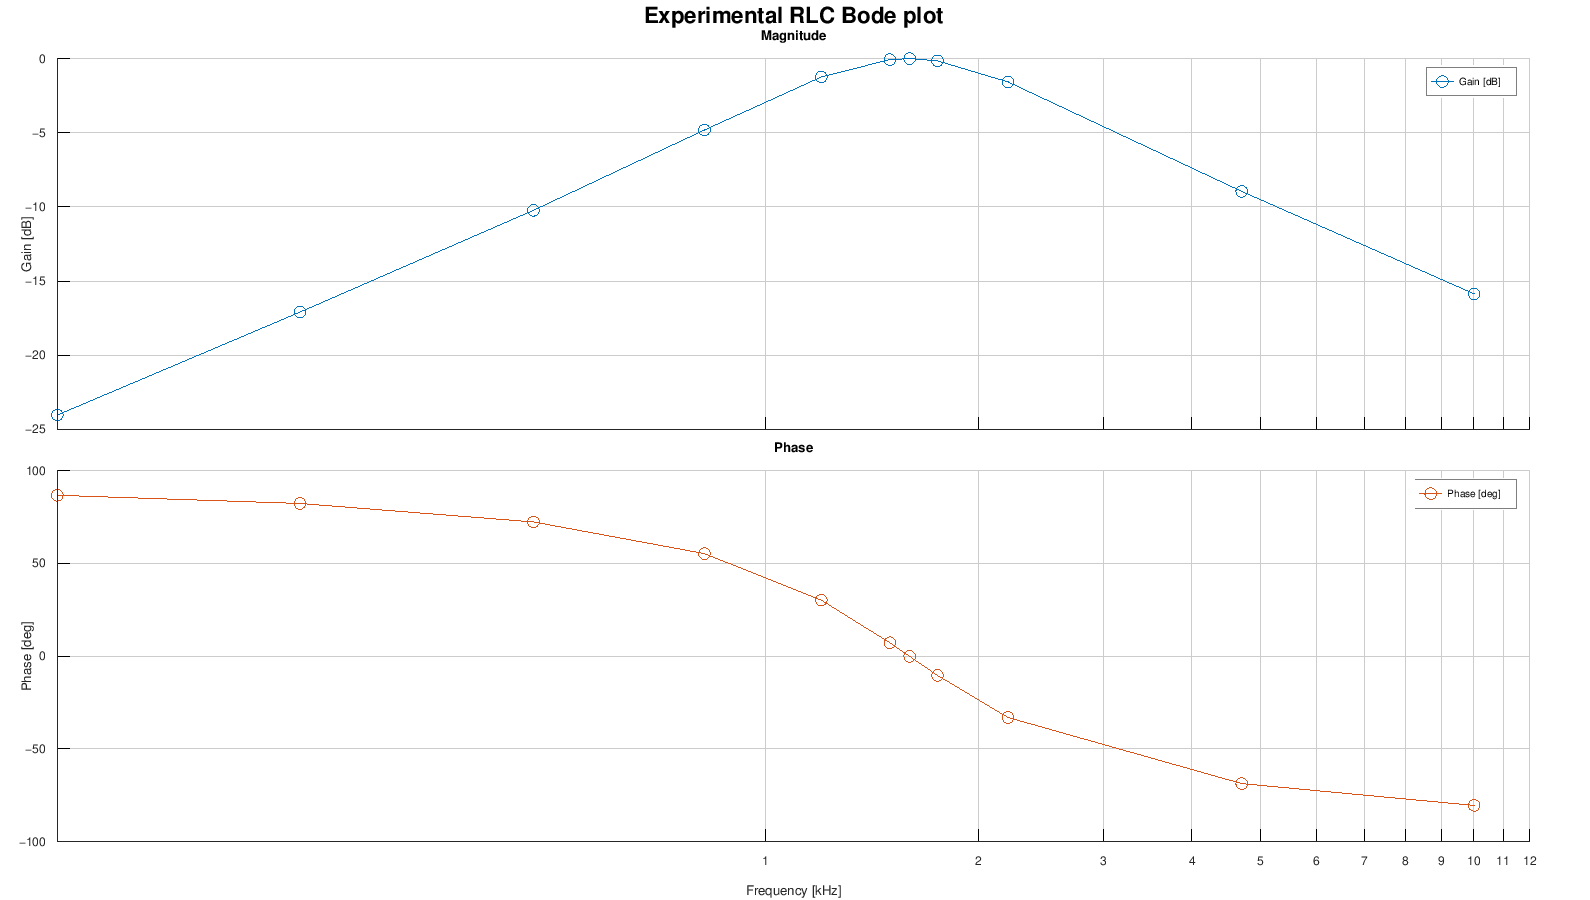
Il dataset di sweep comprende un punto acquisito a circa 1598 Hz, dove il risultato estratto è vicino a 0 dB e la fase è prossima a zero: il comportamento atteso per la tensione sulla resistenza in prossimità della risonanza.
undici waveform Dataset
        ↓
Analysis Source Map
        ↓
Schema + metadata pubblici
        ↓
lettura CANONICAL_DATASET_API_v2
        ↓
fit sinusoidale con NUMERIC_API_v1
        ↓
frequenza, gain, phase, diagnostica
        ↓
DATASET_PUBLICATION_API_v2
        ↓
tutorial.rlc_bode_experimental
        ↓
PLOT_DATASET_API_v3 / new_spec + create_plot
        ↓
plot.dataset.xy : Variant persistente
        ↓
Plots / Axes / Legend / Graphics / Variants / export
Questa separazione è fondamentale: il Dataset derivato è il risultato scientifico; il grafico è una rappresentazione persistente di quel Dataset. Ricalcolo e presentazione restano quindi concettualmente distinti.
Il percorso riproducibile usa uno script registrato nella Session. Nel pannello di configurazione di analysis.octave_script si seleziona registered_script e si associano le acquisizioni tramite Analysis Source Map.
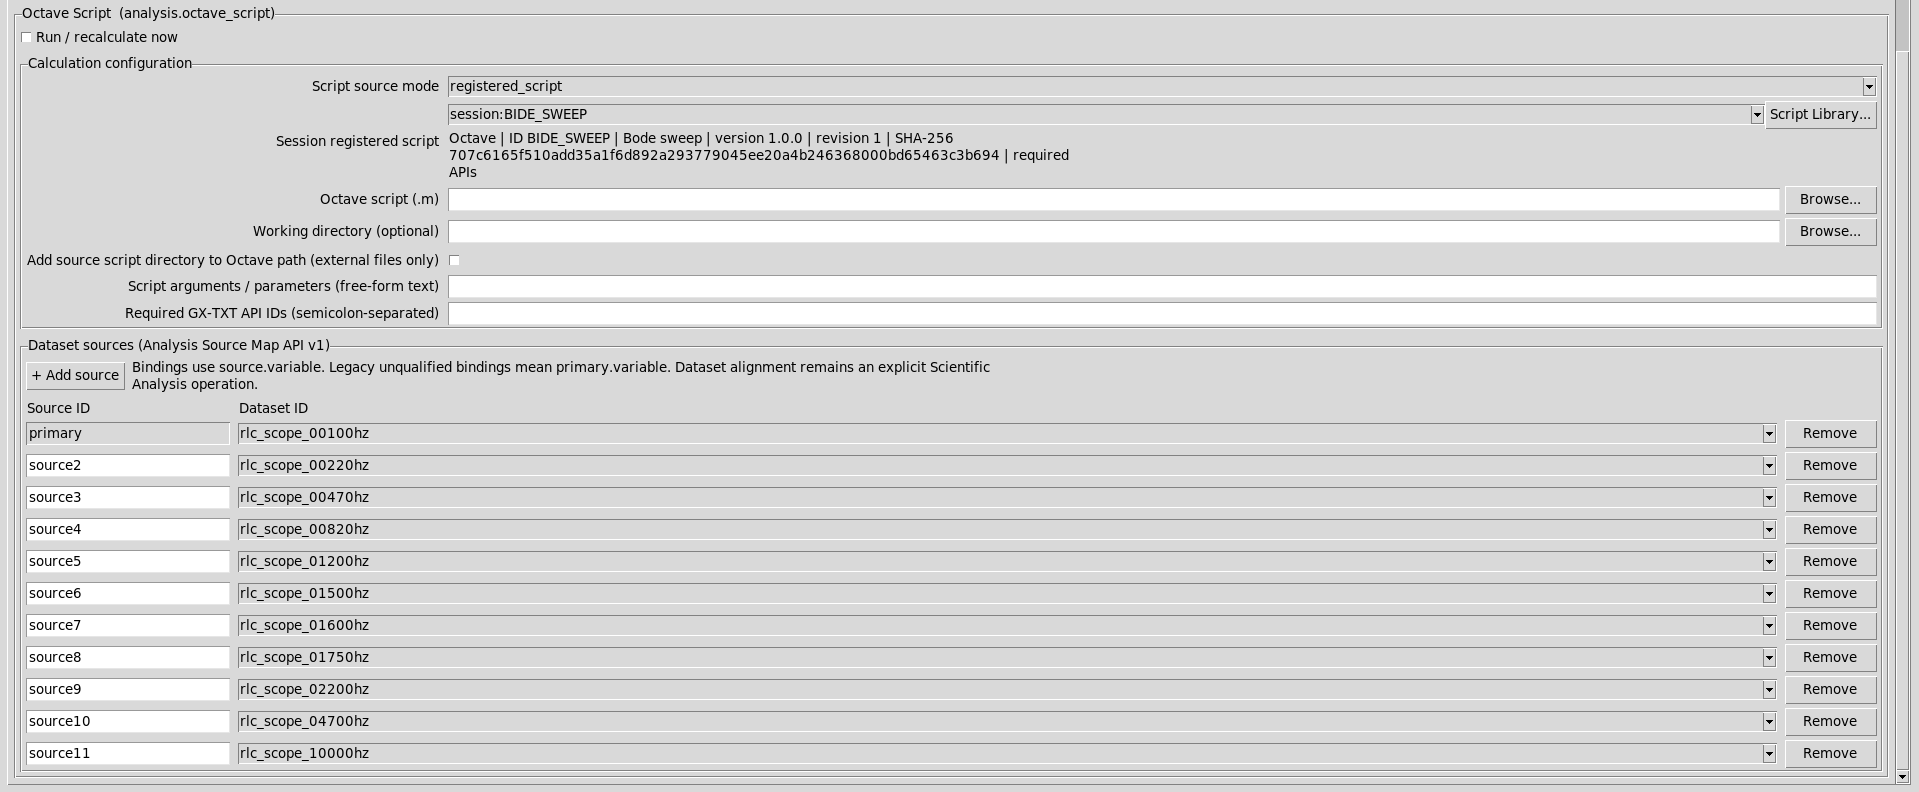
dataset_id.All'inizio dello script il contesto viene ottenuto con:
ctx = gxtxt_context();

aliases = fieldnames(ctx.inputs);
source_ids = {};
for k = 1:numel(aliases)
  item = ctx.inputs.(aliases{k});
  if (isstruct(item) && isfield(item,'dataset_id') && !isempty(item.dataset_id))
    source_ids{end+1} = item.dataset_id;
  endif
endfor
source_ids = unique(source_ids,'stable');
La conseguenza è importante: lo script non deve sapere dove siano fisicamente memorizzati i CSV/HDF5 della Session. Gli bastano le identità pubbliche dei Dataset.
Lo script dichiara subito le API di cui ha bisogno. Se una manca o è incompatibile, il run fallisce prima di produrre un risultato parziale:
gxtxt_api_require({
  'CANONICAL_DATASET_API_v2@2',
  'DATASET_VARIABLE_SCHEMA_API_v3@3',
  'DATASET_METADATA_API_v1@1',
  'NUMERIC_API_v1@1:math.numeric+complex_linear_algebra',
  'DATASET_PUBLICATION_API_v2@2',
  'PLOT_DATASET_API_v3@3:plot.dataset+plotspec',
  'SESSION_PERSISTENCE_API_v1@1'
});CANONICAL_DATASET_API_v2DATASET_VARIABLE_SCHEMA_API_v3DATASET_METADATA_API_v1NUMERIC_API_v1DATASET_PUBLICATION_API_v2PLOT_DATASET_API_v3SESSION_PERSISTENCE_API_v1
| API | Ruolo nel tutorial |
|---|---|
DATASET_VARIABLE_SCHEMA_API_v3 | Trova gli ID stabili delle variabili time_s, vin_V, vout_V e frequency_Hz. |
CANONICAL_DATASET_API_v2 | Descrive e legge i valori dei Dataset sorgente. |
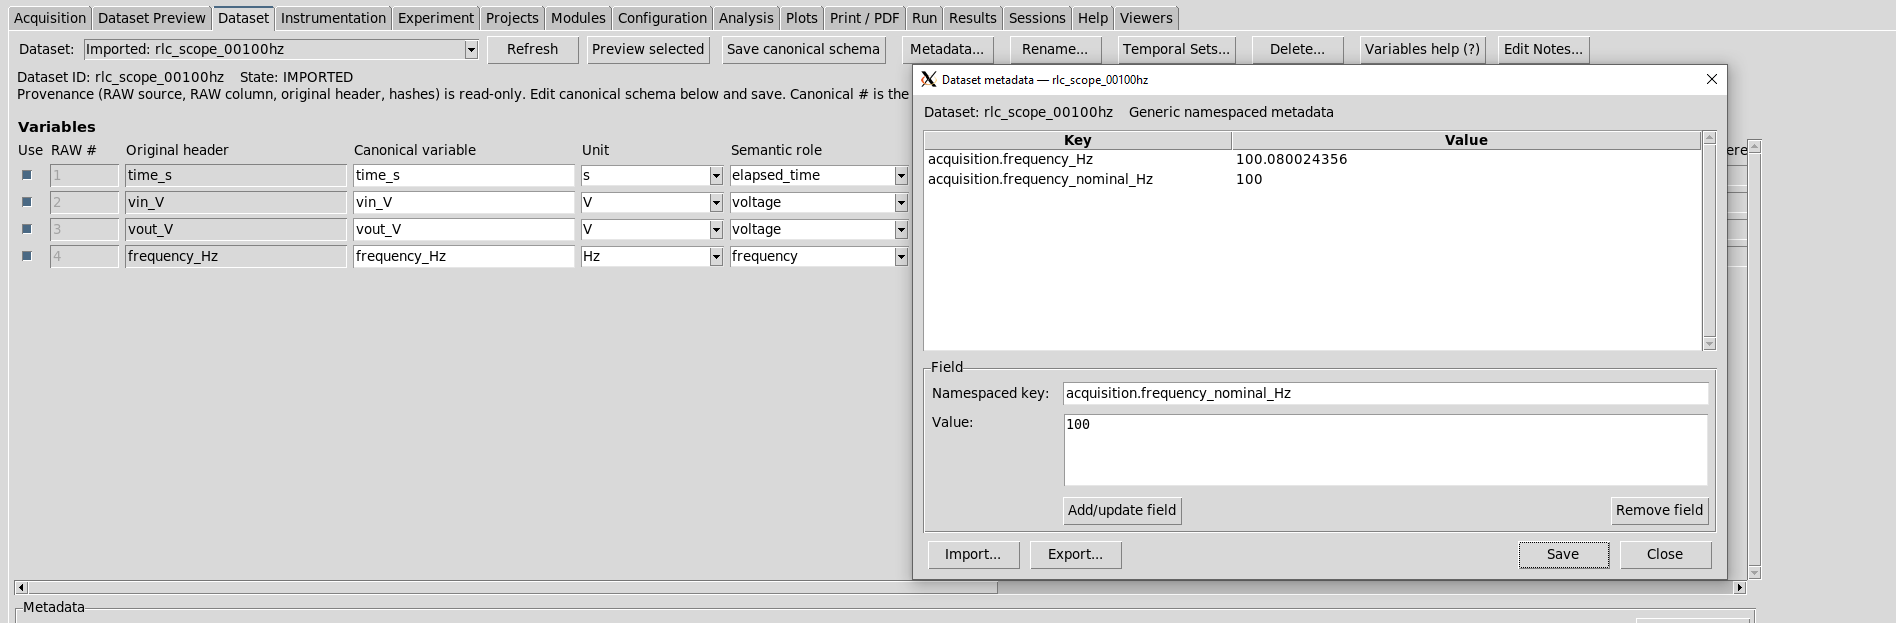
DATASET_METADATA_API_v1 | Legge la frequenza effettiva di acquisizione come metadata namespaced. |
NUMERIC_API_v1 | Calcola sin/cos, risolve il least-squares, ricava ampiezza, fase e guadagno in dB. |
DATASET_PUBLICATION_API_v2 | Pubblica il risultato come Dataset canonico GX-TXT. |
PLOT_DATASET_API_v3 | Costruisce, valida, crea e renderizza il normale grafico persistente. |
SESSION_PERSISTENCE_API_v1 | Rende visibile lo stato appena pubblicato ai processi di rendering e lo conserva nella Session. |
Ogni acquisizione espone quattro variabili canoniche. Il tutorial cerca le variabili per nome/label/ID e poi usa sempre il variable_id stabile restituito dallo schema.
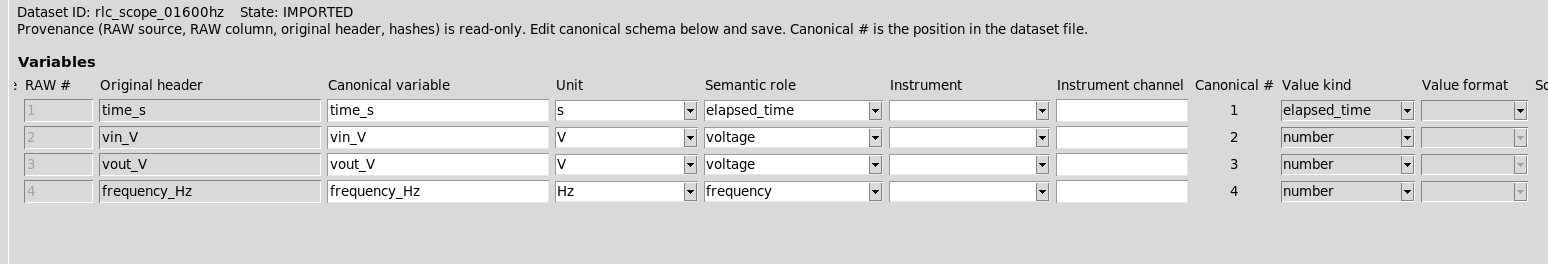
schema = gxtxt_api_call(
    'DATASET_VARIABLE_SCHEMA_API_v3',
    'list',
    {dataset_id});
Dopo aver individuato gli ID necessari, il record viene letto tramite la Canonical Dataset API:
meta = gxtxt_api_call(
    'CANONICAL_DATASET_API_v2',
    'describe',
    {dataset_id});

block = gxtxt_api_call(
    'CANONICAL_DATASET_API_v2',
    'read_range',
{dataset_id, read_ids, 0, meta.row_count});Nel test la frequenza è disponibile sia come variabile costante frequency_Hz sia come metadata. Lo script privilegia acquisition.frequency_Hz, cioè la frequenza effettiva associata alla cattura, e usa la colonna come fallback. Se entrambe sono presenti ma differiscono di oltre l'1%, viene emesso un warning.
Per ogni cattura la frequenza è già nota. Non serve quindi stimare uno spettro completo: si può adattare direttamente ciascun canale alla base sinusoidale della frequenza di eccitazione.
Per \(\omega=2\pi f\):
\[ v(t)=a\sin(\omega t)+b\cos(\omega t)+c. \]
La matrice del problema lineare è:
\[ A = \begin{bmatrix}\sin(\omega t)&\cos(\omega t)&1\end{bmatrix}. \]
Lo script calcola seno e coseno attraverso il servizio numerico e risolve contemporaneamente ingresso e uscita:
sin_r = gxtxt_api_call(
    'NUMERIC_API_v1','array_unary',
    {'sin',struct('kind','vector','value',theta(:))});
cos_r = gxtxt_api_call(
    'NUMERIC_API_v1','array_unary',
    {'cos',struct('kind','vector','value',theta(:))});

A = [sin_r.values(:), cos_r.values(:), ones(numel(t),1)];
B = [vi(:), vo(:)];

fit = gxtxt_api_call(
    'NUMERIC_API_v1','linear_matrix',
    {'solve',struct('real',A),struct('real',B),struct('rank_policy','error')});
beta = double(fit.value_real);
Dai coefficienti:
\[ A_v=\sqrt{a^2+b^2}, \qquad \phi=\operatorname{atan2}(b,a). \]
Si ottengono quindi:
gain_linear = Aout / Ain
gain_dB     = 20 * log10(gain_linear)
phase_deg   = phase_out - phase_in
La fase è riportata nell'intervallo \([-180,+180)\) e lo script conserva anche offset e RMSE dei due fit. Queste quantità diagnostiche diventano colonne del Dataset derivato, invece di andare perse una volta costruito il grafico.
| Frequenza [Hz] | Gain [dB] | Fase [deg] |
|---|---|---|
| 100.080 | -24.027 | +86.760 |
| 220.262 | -17.092 | +82.335 |
| 470.459 | -10.224 | +72.383 |
| 820.216 | -4.814 | +55.278 |
| 1199.299 | -1.234 | +30.185 |
| 1498.299 | -0.063 | +7.242 |
| 1598.230 | -0.0009 | -0.130 |
| 1749.099 | -0.151 | -10.357 |
| 2200.747 | -1.569 | -33.064 |
| 4704.796 | -8.950 | -68.735 |
| 10011.815 | -15.862 | -80.432 |
Il massimo è prossimo alla risonanza teorica e il passaggio della fase attraverso lo zero avviene nella stessa regione. Questo controllo fisico è importante: un workflow API-correct non è automaticamente scientificamente corretto.
Il passaggio successivo non è “fare il grafico”, ma registrare il risultato numerico come un nuovo oggetto scientifico della Session:
dataset_id = 'tutorial.rlc_bode_experimental';

definition = struct();
definition.dataset_id = dataset_id;
definition.contract = 'table.generic';
definition.storage = 'auto';
definition.replace_owned = true;
definition.source_dataset_ids = source_ids;
definition.source_variable_ids = source_variable_ids;

writer = gxtxt_api_call(
    'DATASET_PUBLICATION_API_v2','begin',{definition});
Viene dichiarata una dimensione row estendibile e poi le dieci variabili del risultato:
append per la tabellaLe variabili condividono tutte la stessa dimensione row. Lo script le pubblica quindi con un unico append allineato:
append_data = struct();
for ii = 1:numel(output_ids)
  append_data.(output_ids{ii}) = output_values{ii}(:);
endfor

gxtxt_api_call(
    'DATASET_PUBLICATION_API_v2','append',
    {writer,'row',append_data});

published = gxtxt_api_call(
'DATASET_PUBLICATION_API_v2','finalize',{writer});{} è column-major. La versione verificata alloca esplicitamente output_values=cell(1,10) e assegna ogni colonna per indice. È un dettaglio piccolo, ma può associare vettori numericamente corretti agli ID variabile sbagliati.Qui si trova il passaggio più importante del tutorial. Nella dev-037 lo Script Bridge espone il normale lifecycle di PLOT_DATASET_API_v3. Uno script può quindi creare una Variant ordinaria esattamente come un altro consumer pubblico del framework.
spec = gxtxt_api_call(
    'PLOT_DATASET_API_v3','new_spec',
    {'plot.dataset.xy','Experimental RLC Bode plot'});
Il PlotSpec contiene due pannelli, entrambi collegati allo stesso Dataset derivato.
gain_series = struct(
    'id','gain',
    'dataset_id',dataset_id,
    'x_variable_id','v_frequency_hz',
    'y_variable_id','v_gain_db',
    'axis','left',
    'kind','line_marker',
    'label','Gain');

phase_series = struct(
    'id','phase',
    'dataset_id',dataset_id,
    'x_variable_id','v_frequency_hz',
    'y_variable_id','v_phase_deg',
    'axis','left',
    'kind','line_marker',
    'label','Phase');
Non vengono passati array “sciolti” al renderer: le serie puntano a identità scientifiche persistenti.
xaxis = struct('label','Frequency [Hz]','scale','log');

p1 = struct();
p1.id = 'main';
p1.title = 'Magnitude';
p1.axes = struct('x',xaxis,'y_left',struct('label','Gain [dB]'));
p1.annotations = {};
p1.series = {gain_series};

p2 = struct();
p2.id = 'phase';
p2.title = 'Phase';
p2.axes = struct('x',xaxis,'y_left',struct('label','Phase [deg]'));
p2.annotations = {};
p2.series = {phase_series};

spec.multi_panel = 1;
spec.panels = {p1,p2};plot_valid = gxtxt_api_call(
'PLOT_DATASET_API_v3','validate_spec',{spec});
plot_ref = gxtxt_api_call(
'PLOT_DATASET_API_v3','create_plot',
{spec,'variant'});create_plot vs upsert_plot. Per un normale script interattivo che vuole aggiungere un grafico alla Session, il percorso corretto è create_plot. upsert_plot serve invece a un producer stabile che vuole ritrovare e aggiornare la propria Variant attraverso una provider key. Sono due casi d'uso diversi.gxtxt_api_call('SESSION_PERSISTENCE_API_v1','commit',{});
render_result = gxtxt_api_call(
'PLOT_DATASET_API_v3','render',{plot_ref});
plot_artifacts = gxtxt_api_call(
'PLOT_DATASET_API_v3','artifacts',{plot_ref});Il riferimento ottenuto ha la forma:
module_id  = plot.dataset
graph_id   = plot.dataset.xy
variant_id = p0002    % esempio della Session verificata
Il variant_id concreto dipende dalla Session. Non va hardcodato.
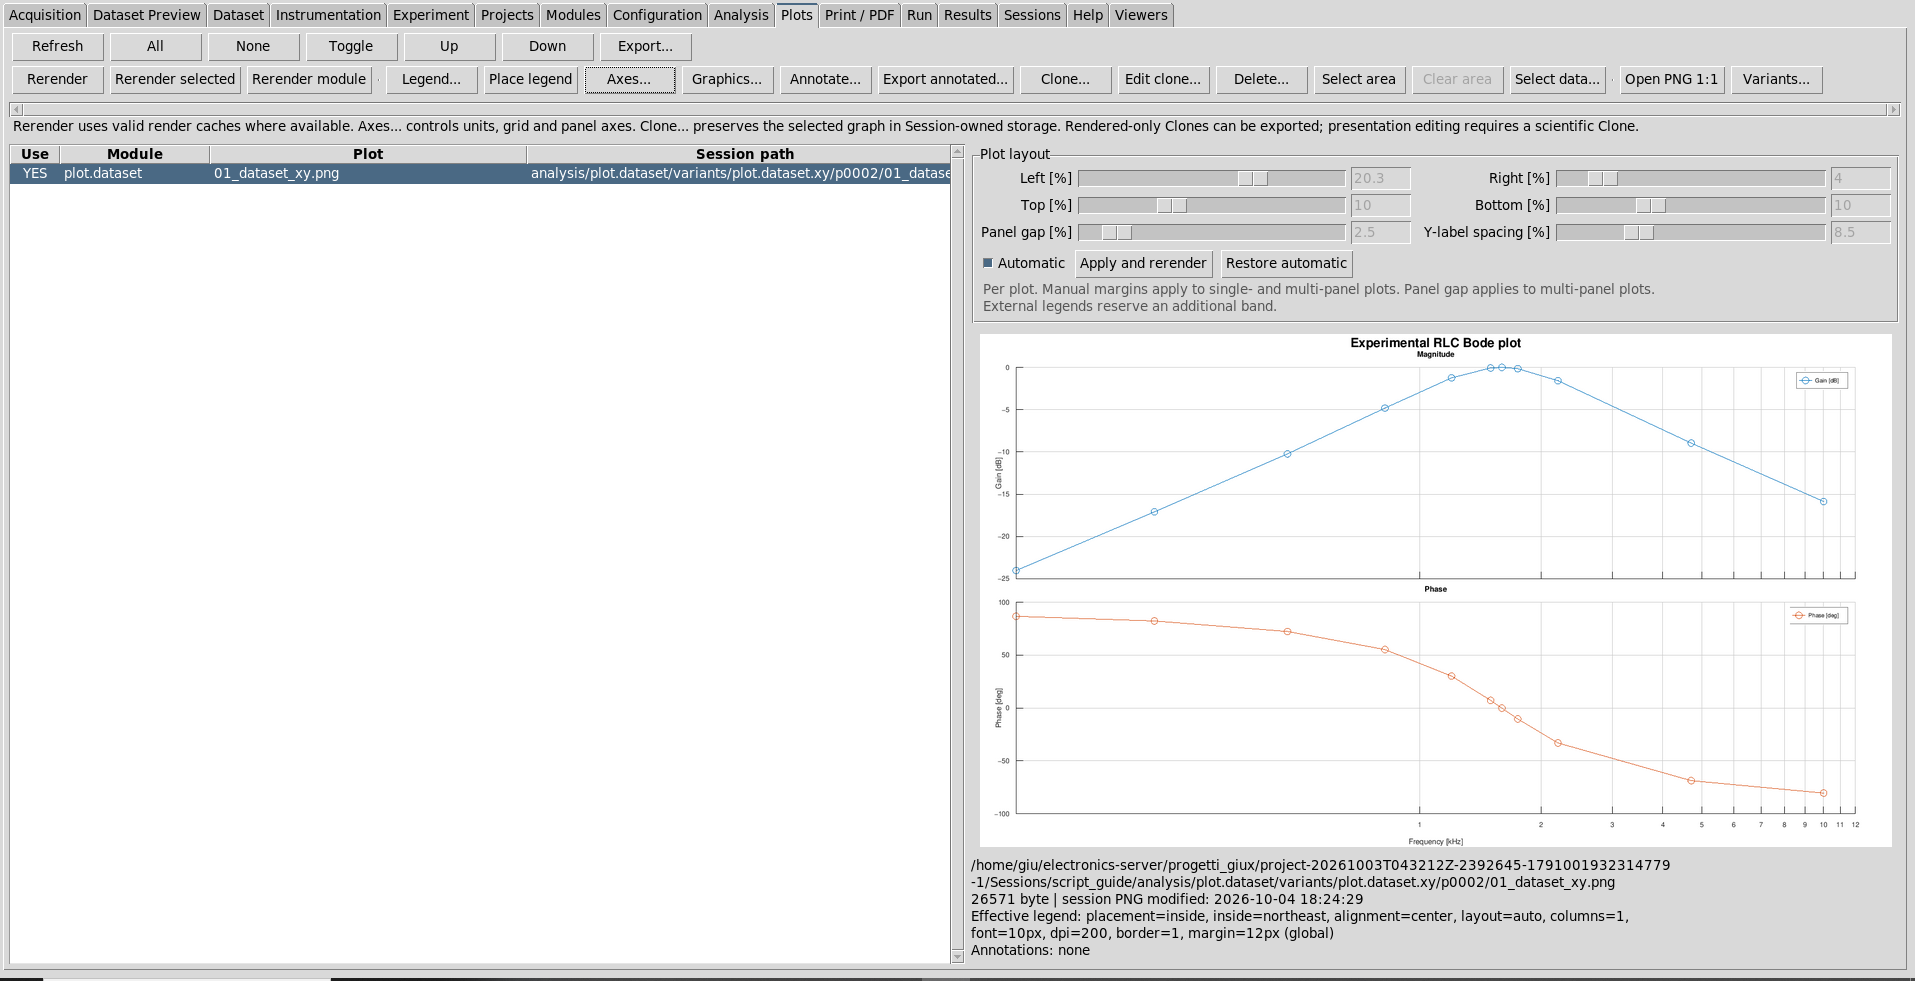
Questo è il punto che distingue l'integrazione da una semplice immagine prodotta con plot(): GX-TXT conosce ancora il Dataset sorgente, le variabili, i pannelli e lo stato persistente del grafico.
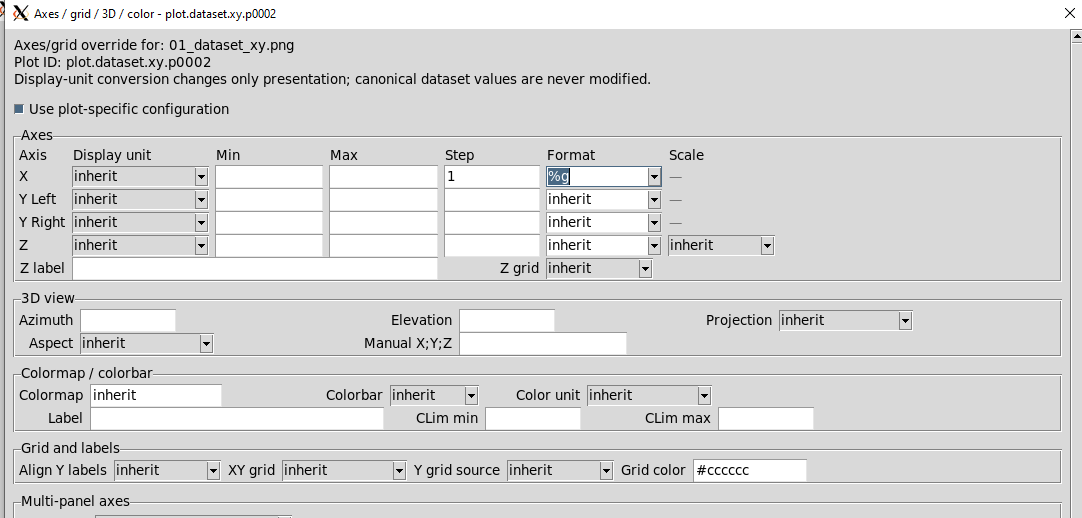
plot.dataset.xy:p0002. Le modifiche di unità, scala, griglia e presentazione non riscrivono i valori canonici del Dataset.Nel Dataset la frequenza resta in Hz. Il renderer può visualizzarla in kHz tramite il normale sistema di unità del framework. La conversione è quindi presentation state, non una mutazione dei dati scientifici.
La parte RLC è solo un esempio. Lo schema di integrazione è riutilizzabile in molti script di ricerca:
% 1. Contesto e preflight
ctx = gxtxt_context();
gxtxt_api_require({...});

% 2. Leggere input con Dataset/Variable IDs pubblici
schema = gxtxt_api_call('DATASET_VARIABLE_SCHEMA_API_v3','list',{dataset_id});
data   = gxtxt_api_call('CANONICAL_DATASET_API_v2','read_range',{...});

% 3. Calcolare con Octave e/o servizi GX-TXT
result = ...;

% 4. Pubblicare il risultato scientifico
dataset_ref = gxtxt_api_call('DATASET_PUBLICATION_API_v2', ...);

% 5. Descrivere il grafico con PlotSpec
spec = gxtxt_api_call('PLOT_DATASET_API_v3','new_spec',{graph_id,title});
% ... Dataset/Variable series, panels, axes ...

% 6. Creare una normale Variant
plot_ref = gxtxt_api_call('PLOT_DATASET_API_v3','create_plot',{spec,'variant'});

% 7. Render attraverso il provider ufficiale
gxtxt_api_call('SESSION_PERSISTENCE_API_v1','commit',{});
gxtxt_api_call('PLOT_DATASET_API_v3','render',{plot_ref});| Specifico di questo esperimento | Riutilizzabile in altri script |
|---|---|
Variabili vin_V, vout_V, frequenza di eccitazione. | Analysis Sources e identità Dataset/Variable. |
Fit sin/cos/DC a frequenza nota. | Uso di NUMERIC_API_v1 e callback/linear algebra pubbliche. |
| Gain, fase e diagnostica RMSE. | Dataset Publication v2 con provenance verso le sorgenti. |
| Bode con due pannelli Magnitude/Phase. | PlotSpec, Graph Series, Variant, render e artifact discovery. |
| Asse X logaritmico di frequenza. | Separazione fra unità canoniche e unità di presentazione. |
plot() e fermarsi al PNG. È utile per debug locale, ma non crea un oggetto grafico GX-TXT persistente.plot.dataset. Usa sempre le API pubbliche.variant_id. Viene restituito da create_plot.create_plot con upsert_plot. Il secondo è per producer stabili.row devono essere scritte coerentemente.Lo script usa sintassi .m largamente compatibile con MATLAB/Octave, ma il runtime ufficiale del GX-TXT Script Workspace è GNU Octave. Funzioni come gxtxt_context(), gxtxt_api_require() e gxtxt_api_call() sono fornite da GX-TXT durante l'esecuzione e non esistono in una sessione MATLAB standalone. Il valore della compatibilità MATLAB è quindi soprattutto nel linguaggio numerico e nella portabilità del codice scientifico, non nell'esistenza di un secondo runner GX-TXT.
Il file seguente è mantenuto intenzionalmente come sorgente separato dal tutorial: permette di confrontare il testo didattico con il codice realmente provato e di importarlo nel Workspace senza copiarlo dalla pagina.