Versione verificata
| Framework | GX-TXT 0.9.8.10-dev-031 |
|---|---|
| Modulo | acq.generic_csv · version 2 |
| Output tipico | table.generic oppure il contract scelto per la riga |
1. Quando usare Generic CSV
Usalo quando la sorgente è una tabella testuale delimitata e non richiede un parser scientifico/vendor specifico. È adatto sia a una tabella singola sia a Session con molti CSV indipendenti.
Non esegue join, interpolazione, resampling o allineamento scientifico fra file: ogni CSV diventa un Dataset separato. Le relazioni fra Dataset vengono costruite successivamente dagli Analysis Sources o da moduli specifici.
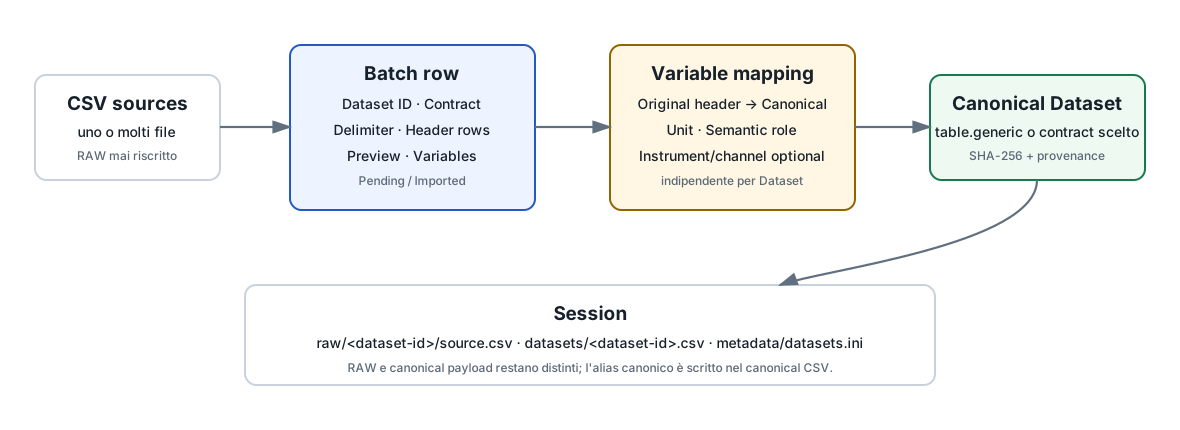
2. Import singolo e batch
La modalità storica a file singolo rimane supportata. Per importare più Dataset nella stessa Session usa la tabella batch.
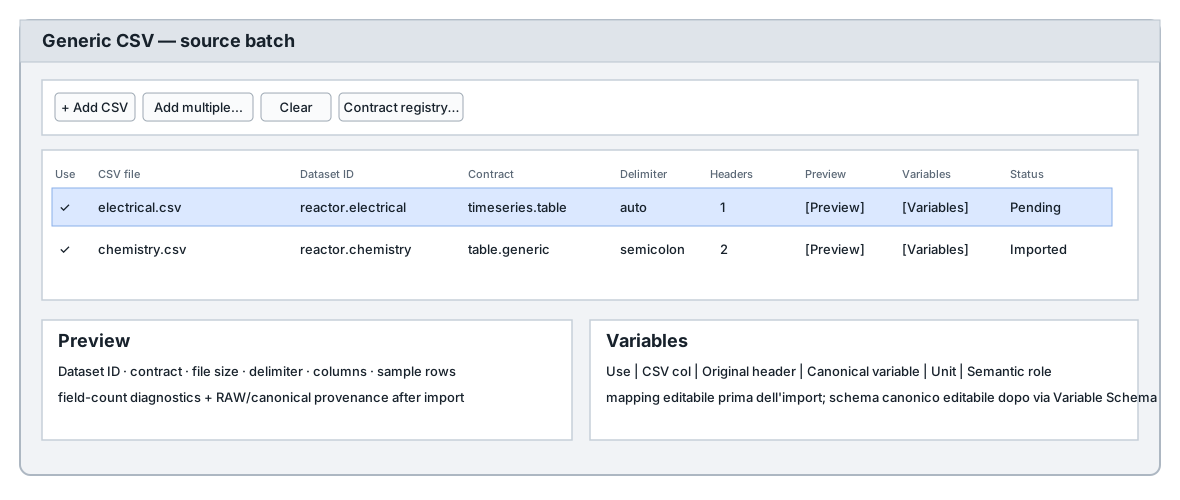
2.1 Campi principali
| Campo | Funzione |
|---|---|
| Dataset ID | Identità canonica stabile del Dataset. |
| Contract | Contratto scientifico, scelto dal Contract Registry oppure inserito come custom. |
| Delimiter | auto, comma, semicolon o tab. |
| Header rows | Numero di righe di intestazione. |
| Preview | Ispeziona struttura e righe campione senza dover aprire manualmente il CSV. |
| Variables | Configura mapping Original header → Canonical variable e relativi metadata. |
3. Dataset ID e contract
Il Dataset ID deve essere unico nella Session. I contract conosciuti vengono proposti dal Contract Registry; la documentazione storica cita fra i contract generici table.generic, timeseries.table, curve_family.table e raw.csv.
Se il contract corretto appartiene a un plugin o a un dominio specifico, usa quello esatto. Un custom contract viene conservato letteralmente anche se il provider originale non è più presente.
4. Preview prima dell’import
La Preview mostra almeno stato, Dataset ID, contract, file, dimensione, delimiter, header rows, numero colonne, righe campionate, mapping corrente e diagnostica semplice sulla consistenza del numero di campi.
Per un Dataset già importato mostra anche provenance disponibile, incluso RAW e checksum canonico quando registrati.
5. Variables mapping
Il workspace Variables mette fianco a fianco:
Use | CSV col | Original header | Canonical variable | Unit | Semantic role | Instrument | Instrument channelEsempio:
Vg1_V    → Vg
Ib_mA    → Ia
Ig1_mA   → Ig
Il canonical CSV prodotto conterrà Vg,Ia,Ig; il RAW conserva invece le intestazioni originali.
6. Unit e Semantic role
Unità e ruolo semantico possono essere impostati per variabile. Dopo l'import, lo schema canonico può essere aggiornato attraverso Dataset Variable Schema senza modificare il RAW.
La semantic role è un hint scientifico; non sostituisce il Variable ID e non effettua automaticamente matching o conversioni fra Dataset diversi.
7. Dataset Metadata
I metadata generici del Dataset sono separati dal Variable Schema. Dopo l'import puoi usare Variables → Metadata... per aggiungere o modificare campi come descrizione, condizioni sperimentali, strumenti o provenance di dominio.
Questo non riscrive il canonical CSV né il RAW.
8. Import incrementale nella Session corrente
Dopo che la Session esiste puoi aggiungere nuove righe alla batch table. Il comando Import enabled pending into current session importa soltanto righe che sono contemporaneamente:
Use = enabled
AND
Status = Pending
Una riga il cui Dataset ID è già registrato appare come Imported e non viene reinserita silenziosamente.
9. Struttura risultante
session/
├── raw/
│   └── <dataset-id>/
│       └── source.csv
├── datasets/
│   └── <dataset-id>.csv
└── metadata/
    ├── datasets.ini
    └── manifest.ini
La struttura fisica è implementation/storage state. Per consumare i dati usa Dataset ID, Variable ID e le API pubbliche.
10. Usare più Dataset in Analysis
Analysis Source Map assegna i Dataset a ruoli espliciti:
primary      → reactor.electrical
uncertainty  → uncertainty_profile
I bindings possono poi riferirsi a variabili qualificate, senza eseguire implicitamente join o resampling.
11. Errori comuni
- Usare il filename come identità scientifica senza rivedere il Dataset ID proposto.
- Scegliere un contract generico quando ne esiste uno specifico per il consumer.
- Saltare Preview/Variables e scoprire solo dopo che gli header non sono quelli attesi.
- Confondere Original header con Canonical variable.
- Aspettarsi che il batch allinei automaticamente file con lunghezze o assi diversi.