Versione verificata
| Framework | GX-TXT 0.9.8.10-dev-031 |
|---|---|
| Contratti principali | CANONICAL_DATASET_API_v2 · DATASET_VARIABLE_SCHEMA_API_v3 · DATASET_METADATA_API_v1 |
1. Dataset ID: l'identità logica
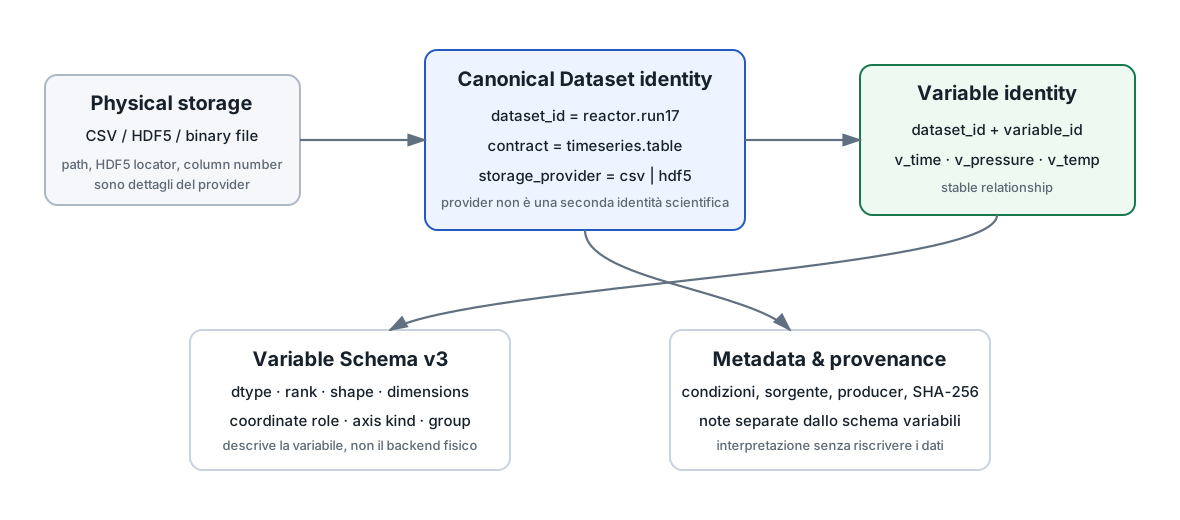
Ogni Dataset canonico possiede un ID stabile, ad esempio reactor.run17, wav.decoded.spectrum o expanded_mesh. Questo ID è l'identità usata da moduli, script, Graph Series, selections e altre risorse.
Il Dataset conserva inoltre un scientific contract, una descrizione dello schema e la provenance. Il contract aiuta i consumer a sapere quale classe di dato possono aspettarsi.
2. Storage provider non significa identità scientifica
Un Dataset può usare un provider CSV o HDF5. Il provider dichiara capability come lettura bounded, random access, chunk read, hyperslab, multidimensionalità, implicit axis e typed binary transport.
Queste capability influenzano come CORE legge il payload. Non cambiano che cosa è il Dataset. Un consumer non dovrebbe scegliere un Dataset perché «è un HDF5», se ciò che gli serve è un determinato contract e schema.
3. Variable ID
L'identità pubblica di una variabile è la coppia:
dataset_id + variable_idUn Variable ID può essere generato come v0001 oppure avere un nome stabile esplicito come time, pressure o frequency. La label visuale e il canonical name possono cambiare senza dover trasformare il percorso fisico del payload nella nuova identità.
4. Variable Schema v3
| Campo | Significato |
|---|---|
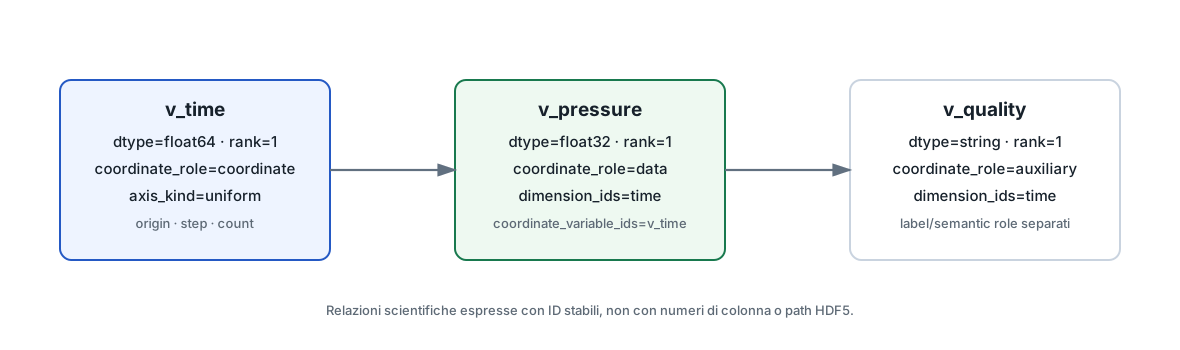
dtype | Tipo logico numerico o stringa. |
rank | Numero di dimensioni; zero indica uno scalare. |
shape | Dimensioni logiche. |
dimension_ids | ID stabili delle dimensioni. |
coordinate_variable_ids | Relazioni con variabili coordinate. |
coordinate_role | data, coordinate o auxiliary. |
axis_kind | explicit, uniform o none. |
axis_origin/step/count | Descrizione compatta di una coordinata uniforme. |
component_ids | Relazione fra componenti di un insieme vettoriale. |
group_id | Identità logica di gruppo. |
5. Coordinate uniformi implicite
Una coordinata con axis_kind=uniform può essere definita da origin, step e count senza memorizzare una colonna completa. Una read bounded ricostruisce soltanto i valori richiesti:
value[i] = origin + (start + i) * stepQuesto è particolarmente utile per frequenza, tempo e assi regolari in Dataset grandi.
6. Lettura con Canonical Dataset API v2
L'API è backend-neutral. La reference completa espone più operazioni a CORE e Tcl; attraverso Script Bridge la dev-031 espone list, describe e read_range.
# Python
description = gxtxt_api_call(
    "CANONICAL_DATASET_API_v2", "describe", [dataset_id]
)
block = gxtxt_api_call(
    "CANONICAL_DATASET_API_v2", "read_range",
    [dataset_id, ["v_pressure"], 0, 4096]
)
Per Dataset grandi usa range bounded o Table Stream invece di materializzare sempre l'intero payload.
7. Tabelle, matrici, field e dati multidimensionali
Variable Schema v3 non è limitato alle tabelle CSV. Può descrivere matrici, field, coordinate di mesh, traiettorie e componenti vettoriali. Le relazioni scientifiche restano espresse tramite ID stabili.
Una generica range read non appiattisce silenziosamente variabili multidimensionali: le operazioni appropriate devono rendere esplicita la geometria richiesta.
8. Metadata, schema e note sono cose diverse
| Risorsa | Contiene |
|---|---|
| Variable Schema | dtype, shape, coordinate, dimensioni e relazioni strutturali. |
| Dataset Metadata | campi generici/domain-specific: condizioni, descrizione, strumento, origine. |
| Dataset Notes | testo scientifico libero dell'utente. |
| Dataset Registry / provenance | identità, contract, storage, producer e integrità. |
Modificare metadata o note non significa riscrivere il payload scientifico originale.
9. Elapsed time
Per variabili value_kind=elapsed_time con rappresentazione HMS, le letture tipizzate espongono numericamente i secondi. L'unità dichiarata resta metadata e non deve provocare una seconda conversione implicita nel consumer.
10. Dataset derivati e Publication API
Un Analysis module o script non dovrebbe scrivere direttamente dentro metadata/datasets.ini. La pubblicazione di un nuovo Dataset passa attraverso Dataset Publication API. L'API gestisce provider, writer, schema, validazione, SHA-256, placement atomico e commit del registry.
Per file scientifici già completati esiste Dataset File Publication API v1.
11. Selections e Temporal Sets non copiano il Dataset
Una Dataset Selection descrive un intervallo o rettangolo attraverso ID stabili e coordinate. Un Temporal Set descrive segmenti o finestre temporali riusabili. Entrambe sono viste/riferimenti sui Dataset canonici; non creano automaticamente copie filtrate dei campioni.
12. Graph Series e plotting
Nel 2D, una Graph Series mantiene almeno dataset_id + x_variable_id + y_variable_id come identità scientifica della serie. Stile, pannelli, legenda e axis presentation appartengono al livello PlotSpec.
13. Errori da evitare
- Usare il path del CSV come Dataset identity.
- Memorizzare un HDF5 object path come Variable ID.
- Usare solo il nome visuale della variabile quando è disponibile un ID stabile.
- Leggere/scrivere direttamente il Dataset Registry da uno script di ricerca.
- Confondere metadata con schema variabili.
- Creare copie del Dataset solo per rappresentare un intervallo che potrebbe essere una Selection.
- Usare una cache di rendering come fonte scientifica.
14. Riferimenti successivi
- Introduzione a GX-TXT.
- Session Explorer e risorse.
- Guida alle API reference utilizzabili con Script Bridge.
- Scientific Dataset Plot.
- Projects, Experiments e Sessions — dove vivono e come vengono organizzati i Dataset nei workflow.